🎬 Video recap tuần — các tin nóng nhất
Tổng quan tuần này. Tuần 41 chứng kiến bước nhảy vọt quan trọng của các công cụ xử lý dữ liệu và sự kết hợp sâu sắc giữa AI và hạ tầng lakehouse. Polars 2.0 chính thức ra mắt, đưa Streaming Engine và cơ chế spill-to-disk thành mặc định để vượt qua giới hạn bộ nhớ trên máy đơn. Amazon Redshift mở đường cho Apache Iceberg Materialized Views, biến kết quả tính toán thành bảng mở cho mọi engine ngoài cùng đọc. Google BigQuery tích hợp mô hình TimesFM 3.0 trực tiếp vào các hàm SQL để dự báo chuỗi thời gian, trong khi Snowflake đưa công cụ Code Execution của Cortex Agents lên GA để agent tự viết và chạy Python trong sandbox bảo mật. Ở quy mô doanh nghiệp, Accenture và Dell bắt tay lập nhóm kinh doanh chung thúc đẩy Private AI on-premise, khẳng định xu hướng mang mô hình đến gần dữ liệu nội bộ.
T2 05/1010 tinT3 06/105 tinT4 07/103 tinT5 08/104 tinT6 09/103 tinT7 10/100 tinCN 11/100 tin

🗄️ Hạ tầng & Kiến trúc dữ liệu

Snowflake đưa tính năng Backup bảng Iceberg do Snowflake quản lý lên GA

Snowflake chính thức đưa tính năng sao lưu cho các bảng Apache Iceberg do hãng quản lý lưu trữ lên GA, cho phép sao lưu point-in-time và khôi phục sau sự cố tương tự bảng nội bộ.

💡 Người dùng lakehouse giờ có được mức độ bảo vệ dữ liệu cấp doanh nghiệp trên định dạng bảng mở mà không cần tự xây dựng cơ chế snapshot thủ công.

📅 09/10🔗 Website
  • Hỗ trợ sao lưu point-in-time sau sự cố
  • Bảo vệ dữ liệu toàn diện cho bảng mở
  • Giữ nguyên tính tương thích chuẩn Apache Iceberg
  • Quản lý vòng đời sao lưu hoàn toàn tự động
STATUSGATARGETBảng IcebergSCOPESnowflake storageRECOVERYPoint-in-time

Bảng mở mang lại sự tự do tránh bị khóa chặt vào một nhà cung cấp nhưng thường thiếu các công cụ vận hành như sao lưu tự động. Khi Snowflake đưa tính năng này lên GA, khoảng cách vận hành giữa bảng nội bộ và bảng Iceberg được thu hẹp đáng kể. Điểm quan trọng là cơ chế phục hồi point-in-time không làm hỏng metadata hay phá vỡ tính toàn vẹn của catalog. Doanh nghiệp Việt đang cân nhắc lakehouse giờ có thêm lý do để an tâm lưu trữ trên định dạng mở. Tuy nhiên, đội ngũ dữ liệu cần theo dõi chi phí lưu trữ snapshot nếu chu kỳ thay đổi dữ liệu trong ngày quá cao.

BigQuery mở rộng Flexible Column Names cho toàn bộ bảng Apache Iceberg

Google BigQuery chính thức hỗ trợ Flexible Column Names lên GA cho bảng Iceberg ngoại trú, bảng Iceberg quản lý trong BigQuery và bảng do Lakehouse runtime catalog điều phối.

💡 Tháo bỏ rào cản đặt tên cột khi tích hợp dữ liệu từ các hệ thống nghiệp vụ đa ngôn ngữ hoặc có ký tự đặc biệt vào lakehouse.

📅 08/10🔗 Website
  • Hỗ trợ ký tự Unicode, khoảng trắng và ký tự đặc biệt
  • Áp dụng cho cả bảng external và managed Iceberg
  • Đồng bộ cùng Lakehouse runtime catalog
  • Giữ nguyên tên trường nguyên bản từ hệ thống nguồn
STATUSGAFEATUREFlexible ColumnsFORMATApache IcebergENGINEBigQuery

Quy ước đặt tên cột ngặt nghèo của SQL truyền thống thường làm đau đầu các kỹ sư dữ liệu khi nạp dữ liệu từ API hoặc hệ thống ERP có tiếng Việt hay ký tự đặc biệt. Việc mở rộng Flexible Column Names giúp bảng Iceberg giữ nguyên tên trường gốc mà không phải đổi tên phức tạp trong pipeline. Điều này giữ vẹn nguyên ngữ nghĩa nghiệp vụ từ nguồn đến đích mà không làm đứt gãy schema. Dù vậy, team data vẫn nên thận trọng khi truy vấn chéo từ các engine khác như Spark cũ, vì không phải engine nào cũng xử lý mượt tên cột chứa ký tự lạ.

🔥 TOP 1 TUẦN NÀYPolars 2.0 chính thức ra mắt: đưa Streaming Engine thành mặc định cho LazyFrame

Polars 2.0 phát hành chính thức, thiết lập Streaming Engine làm chế độ thực thi mặc định cho LazyFrame, kích hoạt cơ chế spill-to-disk out-of-core, nâng cấp engine SQL first-class và bổ sung kiểu Map.

💡 Đánh dấu bước nhảy vọt biến Polars từ một thư viện DataFrame bộ nhớ thành một engine xử lý dữ liệu hoàn chỉnh vượt xa giới hạn RAM máy đơn.

📅 06/10🔗 Website
  • Streaming Engine thành mặc định cho LazyFrame.collect()
  • Tự động spill-to-disk khi dữ liệu vượt RAM vật lý
  • Trình tối ưu hóa SQL first-class đạt hiệu năng cao
  • Bổ sung Map data type và ổn định API SemVer
VERSION2.0ENGINEStreaming defaultMEMORYOut-of-coreSQLFirst-class

Polars 2.0 không chỉ là bản cập nhật số hiệu mà là cột mốc trưởng thành của công cụ xử lý dữ liệu đơn máy bằng Rust. Việc chuyển sang streaming engine mặc định đồng nghĩa data engineer có thể xử lý tập dữ liệu hàng chục gigabyte trên laptop mà không lo dính lỗi Out Of Memory. Khả năng spill-to-disk xóa nhòa ranh giới giữa một thư viện DataFrame và một database OLAP thực thụ. Đối với các team data vừa và nhỏ, Polars 2.0 giúp trì hoãn việc phải dựng cluster Spark cồng kềnh thêm một thời gian dài. Tuy nhiên, streaming engine có thể thay đổi thứ tự hàng không xác định trong một số phép join, nên các pipeline phụ thuộc thứ tự cần được kiểm thử lại kỹ lưỡng.

🔥 TOP 2 TUẦN NÀYAmazon Redshift hỗ trợ tạo và làm mới Apache Iceberg Materialized Views

Amazon Redshift cho phép tạo materialized view lưu kết quả dưới dạng bảng mở Apache Iceberg trên S3 và Glue Catalog bằng lệnh CREATE MATERIALIZED VIEW ... USING ICEBERG, hỗ trợ refresh gia tăng.

💡 Cầu nối quan trọng xóa bỏ khoảng cách giữa data warehouse và open lakehouse: kết quả pre-compute từ Redshift có thể được truy vấn ngay bởi Athena, Spark hay Trino.

📅 05/10🔗 Website
  • Cú pháp CREATE MATERIALIZED VIEW ... USING ICEBERG
  • Kết quả lưu thành bảng Iceberg chuẩn mở trên Amazon S3
  • Hỗ trợ làm mới gia tăng tái tính toán phần đổi
  • Đa engine Athena, Spark, Trino, Snowflake đọc trực tiếp
ENGINERedshift Serverless & RGFORMATApache IcebergCATALOGAWS GlueREFRESHIncremental

Đây là bước chuyển mang tính biểu tượng của AWS khi biến một tính năng tối ưu nội bộ của data warehouse thành tài sản chia sẻ chung cho toàn bộ hệ sinh thái lakehouse. Trước đây, materialized view trong Redshift bị nhốt trong storage độc quyền, chỉ Redshift đọc được. Giờ đây, một bảng tổng hợp tính toán nặng từ Redshift trở thành bảng Iceberg mở trên S3, sẵn sàng cho Athena, Spark hay dashboard ngoài truy vấn mà không tốn thêm chi phí compute của Redshift. Lợi ích lớn nhất là giảm tải tính toán lặp lại và tiết kiệm chi phí cho toàn hệ thống. Điểm cần lưu ý là tính năng chỉ hỗ trợ trên Serverless và instance Graviton, đòi hỏi doanh nghiệp phải hiện đại hóa cụm Redshift của mình.

Databricks cho phép gán quyền chạy Lakeflow Pipelines theo nhóm tài khoản

Databricks cập nhật tính năng Lakeflow Pipelines cho phép thiết lập định danh thực thi (run-as) thuộc về một nhóm tài khoản (account group) thay vì tài khoản cá nhân hay service principal riêng lẻ.

💡 Giải quyết dứt điểm rủi ro pipeline bị đình trệ khi kỹ sư rời công ty, tăng cường tính sở hữu chung của đội ngũ dữ liệu.

📅 05/10🔗 Website
  • Gán định danh run-as trực tiếp cho account group
  • Pipeline chạy với quyền hạn kế thừa của nhóm
  • Tránh gián đoạn vận hành khi thay đổi nhân sự
  • Tích hợp chặt chẽ vào cơ chế Unity Catalog
STATUSPublic rolloutTARGETLakeflow PipelinesIDENTITYAccount GroupCATALOGUnity Catalog

Trong quản trị dữ liệu thực tế, sự cố ngớ ngẩn nhất nhưng lại phổ biến nhất là pipeline production bỗng nhiên ngừng chạy vì tài khoản của kỹ sư phụ trách vừa bị vô hiệu hóa khi chuyển việc. Việc Databricks cho phép gán quyền run-as theo group giúp chuẩn hóa mô hình sở hữu đội nhóm. Pipeline giờ đây mang quyền hạn tập thể và được quản trị thông qua nhóm Unity Catalog. Đây là bước đi đúng đắn cho các doanh nghiệp đang mở rộng quy mô data team. Khuyến nghị thực tế là nên tạo nhóm chuyên biệt với quyền hạn tối thiểu thay vì dùng nhóm quá rộng.

🛠️ Công cụ & Nền tảng

Snowflake đưa giao diện Snowsight cho tag và chính sách bảo vệ dữ liệu lên GA

Snowflake chính thức đưa giao diện quản trị trong Snowsight lên GA, giúp phân loại dữ liệu qua tag và gán các chính sách bảo vệ (masking, row access policy) bằng giao diện trực quan.

💡 Dân chủ hóa công tác data governance, giúp các data steward và chuyên viên bảo mật cấu hình kiểm soát mà không cần viết lệnh SQL DDL phức tạp.

📅 09/10🔗 Website
  • Quản lý tag và chính sách bảo vệ trực quan trong Snowsight
  • Gán masking policy và row access policy bằng click chuột
  • Theo dõi mức độ tuân thủ và phân loại dữ liệu toàn account
  • Rút ngắn thời gian triển khai quy định an toàn thông tin
STATUSGAUISnowsightGOVERNANCETag & PolicySECURITYMasking & Access

Governance nếu quá phức tạp về mặt câu lệnh sẽ nhanh chóng bị đẩy thành trách nhiệm riêng của kỹ sư hạ tầng, trong khi người hiểu dữ liệu nhất là business steward lại không thể thao tác. Giao diện mới trên Snowsight giải quyết đúng nút thắt trải nghiệm này. Người quản trị có thể nhìn thấy bức tranh phân loại dữ liệu, xem bảng nào chưa gắn tag bảo mật và áp dụng chính sách ẩn dữ liệu chỉ trong vài cú click. Tuy nhiên, đừng để giao diện kéo team rời xa kỷ luật Infrastructure as Code. Các hệ thống lớn vẫn nên lưu trữ định nghĩa chính sách trong Git và dùng UI chủ yếu cho việc audit, giám sát.

Airbyte ra mắt BigQuery Source Connector: đọc 1TB trong chưa đầy 1 giờ

Airbyte ra mắt connector nguồn BigQuery phiên bản 1.0, đạt tốc độ 480 MB/s nhờ tận dụng BigQuery Storage Read API, hỗ trợ giữ nguyên kiểu dữ liệu lồng nhau và tự động resume khi đứt kết nối.

💡 Tăng tốc luồng truyền tải dữ liệu từ BigQuery sang các đích khác gấp hàng trăm lần so với phương pháp query API thông thường.

📅 06/10🔗 Website
  • Tốc độ đạt 480 MB/s, đọc 1TB dưới 60 phút
  • Tận dụng BigQuery Storage Read API nén song song
  • Giữ nguyên cấu trúc STRUCT, ARRAY và JSON bản địa
  • Hỗ trợ resume từ checkpoint khi có sự cố mạng
SPEED480 MB/sVOLUME1TB / 60 phútAPIStorage Read APICONNECTORBigQuery 1.0

Việc trích xuất dữ liệu lớn từ data warehouse như BigQuery để phục vụ các kho dữ liệu vệ tinh, replication hay AI training thường gặp trở ngại về tốc độ và chi phí query API. Bằng cách chuyển sang Storage Read API với các luồng đọc gRPC song song, Airbyte đã giải quyết triệt để vấn đề nghẽn cổ chai này. Việc bảo toàn kiểu dữ liệu bản địa như STRUCT và ARRAY cũng giúp loại bỏ bước parse string tốn kém ở downstream. Với các doanh nghiệp đa đám mây, đây là công cụ đắc lực để đồng bộ BigQuery sang Snowflake, Databricks hay lakehouse riêng một cách kinh tế.

Amazon EMR Serverless nâng trần bộ nhớ Shuffle lên 1TB cho mỗi tác vụ

AWS tăng giới hạn lưu trữ shuffle disk trên Amazon EMR Serverless từ 200GB lên 1TB cho mỗi tác vụ Spark và Hive, giúp giải quyết các bài toán join và sort quy mô cực lớn mà không bị crash.

💡 Tháo gỡ giới hạn vật lý lớn nhất của Spark serverless, giúp người dùng không còn phải duy trì cụm EC2 chuyên dụng chỉ vì lượng shuffle lớn.

📅 06/10🔗 Website
  • Trần shuffle disk tăng gấp 5 lần từ 200GB lên 1TB
  • Áp dụng cho cả tác vụ Apache Spark và Apache Hive
  • Hạn chế tối đa lỗi Out-of-Disk trong các phép join diện rộng
  • Tự động giải phóng lưu trữ sau khi job hoàn thành
LIMIT1TB shuffleMULTIPLIERTăng 5×PLATFORMEMR ServerlessENGINESSpark & Hive

Lỗi thiếu dung lượng đĩa trong giai đoạn shuffle luôn là nỗi sợ lớn của các kỹ sư vận hành Spark serverless khi gặp dữ liệu bị lệch (data skew) hoặc phép join nhiều bảng khổng lồ. Việc nâng trần lên 1TB giúp EMR Serverless tự tin gánh vác các batch job nặng mà trước đây buộc phải chuyển sang cụm EC2 provisioned để gắn thêm ổ EBS. Tuy nhiên, nhiều shuffle storage hơn không đồng nghĩa với việc bạn nên bỏ qua khâu tối ưu mã nguồn. Data skew và thiếu partition key hợp lý vẫn sẽ ngốn chi phí và kéo dài thời gian chạy. Hãy dùng 1TB này như một tấm lưới an toàn thay vì cái cớ để lười tối ưu.

Astronomer đưa Durable Execution vào Airflow 3.3: lưu tiến trình và cache lệnh gọi AI

Astronomer công bố cơ chế thực thi bền bỉ trong Apache Airflow 3.3, cho phép lưu trạng thái tiến trình để khi task gặp lỗi hoặc timeout, việc retry có thể tiếp tục ngay từ bước dở dang.

💡 Giảm thiểu lãng phí compute và chi phí gọi API LLM đắt đỏ khi chạy các pipeline AI dài hơi qua cơ chế checkpoint thông minh.

📅 05/10🔗 Website
  • Task tự động kết nối lại công việc đang chạy khi crash
  • Cache và tái sử dụng kết quả các lệnh gọi API AI thành công
  • Giảm thiểu tính toán lặp lại và chi phí token đắt đỏ
  • Hỗ trợ kiến trúc Airflow 3.3 hiện đại
AIRFLOW3.3FEATUREDurable ExecutionSAVINGCache AI callsVENDORAstronomer

Khi đưa AI và LLM vào pipeline dữ liệu, đặc tính của task thay đổi hoàn toàn: thời gian chạy lâu hơn, tính bất định cao hơn và mỗi lệnh gọi API đều tốn tiền thật. Nếu task chạy đến phút thứ 50 rồi đứt mạng, việc Airflow bắt đầu lại từ đầu là sự lãng phí không thể chấp nhận. Durable execution mang tinh thần của Temporal hay durable workflow vào thẳng Airflow. Việc cache kết quả của các bước gọi model và lưu trạng thái trung gian giúp pipeline phục hồi cực nhanh sau sự cố. Dù vậy, các kỹ sư cần đảm bảo các hành động có tính lặp lại (idempotent) để tránh sinh ra dữ liệu trùng lặp khi retry.

WHOOP tự động hóa pipeline CDC: cập nhật bản sao phân tích mỗi 4 giờ và tự propagate schema

Đội ngũ WHOOP chia sẻ kiến trúc Change Data Capture liên tục, ghi nhận thay đổi từ cơ sở dữ liệu vận hành, cập nhật bản sao phân tích mỗi 4 giờ và tự động đẩy các thay đổi schema xuống downstream.

💡 Loại bỏ gánh nặng bảo trì thủ công của data engineer khi microservices liên tục đổi cột và bảng, giải phóng thời gian cho các bài toán phân tích giá trị cao.

📅 05/10🔗 Website
  • Ghi nhận thay đổi liên tục, cập nhật analytical replica mỗi 4 giờ
  • Tự động đồng bộ thêm bảng và cột mới xuống downstream
  • Phân quyền cho từng service team tự quản lý việc sao chép
  • Tiết kiệm chi phí compute và công sức bảo trì
FREQUENCY4 giờ/lầnPATTERNCDC tự độngTEAMWHOOP EngineeringSCHEMATự propagate

Case study của WHOOP chạm đúng nỗi đau kinh điển của mọi đội ngũ data: kỹ sư backend đổi schema cơ sở dữ liệu nguồn mà không thông báo, làm gãy hàng loạt pipeline downstream. Bằng cách thiết kế hệ thống CDC tự động phát hiện và truyền dẫn schema mới vào tầng phân tích, WHOOP trao quyền tự chủ lại cho các nhóm phát triển dịch vụ. Chu kỳ 4 giờ là một điểm cân bằng thông minh giữa chi phí compute và độ tươi dữ liệu cho phân tích kinh doanh. Đây là bài học thiết kế kiến trúc thực tế đáng giá cho các startup và doanh nghiệp công nghệ đang mở rộng quy mô.

🤖 AI × Data

ARCS: Nghiên cứu làm rõ câu hỏi có cấu trúc giúp nâng cao độ chính xác Text-to-SQL

Bài báo giới thiệu khung làm việc ARCS, chuyển đổi từ hội thoại tự do sang cơ chế làm rõ câu hỏi có cấu trúc để giải quyết triệt để tính mơ hồ của người dùng trước khi sinh mã SQL.

💡 Khắc phục điểm yếu chí mạng của các chatbot phân tích hiện nay: tự đoán mò ý định người dùng và sinh câu truy vấn sai lệch ngữ nghĩa.

📅 08/10🔗 Website
  • Phát hiện các điểm mơ hồ tiềm ẩn trong câu hỏi ngôn ngữ tự nhiên
  • Tạo các lựa chọn làm rõ có cấu trúc chặt chẽ thay vì chat tự do
  • Cải thiện vượt trội độ chính xác của SQL sinh ra trên benchmark phức tạp
  • Giảm thiểu hiện tượng ảo giác khi ánh xạ schema
ARXIV2610.09396PARADIGMStructured DisambiguationTARGETText-to-SQLBENCHMARKĐộ chính xác cao

Trong thực tế triển khai BI và trợ lý dữ liệu, câu hỏi của người dùng kinh doanh thường mơ hồ, ví dụ: 'doanh số tuần này' có thể hiểu là ngày đặt hàng, ngày xuất kho hoặc ngày ghi nhận dòng tiền. Hầu hết các giải pháp Text-to-SQL hiện nay hoặc tự tiện chọn một cột, hoặc sa vào các cuộc trò chuyện tự do lan man làm tăng hallucination. ARCS chọn cách tiếp cận chuẩn xác hơn: agent đưa ra các lựa chọn cấu trúc ngắn gọn để người dùng bấm chọn xác nhận. Đây chính là cách thiết kế UX chuẩn mực mà các sản phẩm AI data hiện đại nên học hỏi để đưa agent vào môi trường production đáng tin cậy.

🔥 TOP 3 TUẦN NÀYGoogle BigQuery tích hợp mô hình nền tảng TimesFM 3.0 trực tiếp vào SQL

Google đưa mô hình TimesFM 3.0 vào BigQuery, cung cấp các hàm SQL tích hợp sẵn gồm AI.FORECAST (hỗ trợ cả đơn biến và đa biến kèm biến phụ trợ), AI.EVALUATE và AI.DETECT_ANOMALIES.

💡 Đem năng lực foundation model chuyên biệt cho chuỗi thời gian vào ngay câu lệnh SQL thông thường, xóa bỏ nhu cầu dựng pipeline xuất dữ liệu ra hạ tầng training riêng.

📅 07/10🔗 Website
  • Tích hợp mô hình TimesFM 3.0 trực tiếp vào BigQuery Studio
  • Hàm AI.FORECAST hỗ trợ dự báo đa biến và biến phụ thuộc
  • Hàm AI.DETECT_ANOMALIES phát hiện bất thường tự động
  • Hỗ trợ gọi trực tiếp từ Conversational Analytics
MODELTimesFM 3.0CAPABILITYĐơn & Đa biếnINTERFACESQL functionsDEPLOYMENTKhông cần GPU riêng

Dự báo chuỗi thời gian và phát hiện bất thường là hai tác vụ kinh điển của phân tích kinh doanh, nhưng trước đây thường đòi hỏi export dữ liệu ra Python, chạy Prophet hoặc dựng cụm inference chuyên biệt. Việc Google tích hợp mô hình TimesFM 3.0 với khả năng xử lý đa biến thẳng vào hàm SQL BigQuery là một bước đột phá về độ tiện dụng. Analyst chỉ cần viết một câu lệnh SQL ngắn là có ngay kết quả dự báo có độ chính xác cao nhờ kiến trúc pretrained foundation model. Tuy nhiên, doanh nghiệp cần chú ý chi phí slot compute khi chạy dự báo trên hàng triệu chuỗi thời gian cùng lúc.

ScyllaDB bổ sung Full-Text Search BM25 trên ScyllaDB X Cloud để phục vụ Hybrid RAG

ScyllaDB 2026.3 ra mắt tính năng Full-Text Search dựa trên xếp hạng BM25 trên ScyllaDB X Cloud, kết hợp cùng Vector Search sẵn có để tạo nên giải pháp tìm kiếm lai hiệu năng cao cho ứng dụng AI.

💡 Giải quyết bài toán tìm kiếm chính xác các mã lỗi, tên sản phẩm và từ khóa kỹ thuật mà vector search thuần túy thường bỏ sót trong hệ thống RAG.

📅 06/10🔗 Website
  • Tìm kiếm toàn văn hiệu năng cao dùng thuật toán BM25
  • Chạy song song cùng Vector Search trên nền tảng C++ phân tán
  • Hỗ trợ tìm kiếm từ khóa chính xác kết hợp tương đồng ngữ nghĩa
  • Loại bỏ nhu cầu duy trì cụm tìm kiếm rời rạc
RELEASEScyllaDB 2026.3ALGORITHMBM25 + VectorCLOUDScyllaDB X CloudUSE CASEHybrid RAG

Cơn sốt vector database ban đầu khiến nhiều team nghĩ rằng chỉ cần biến mọi thứ thành embedding là xong. Nhưng thực tế production đã chứng minh: vector search rất kém trong việc tìm mã định danh chính xác như mã linh kiện, SKU hay mã lỗi. Xu hướng chuẩn hiện nay là Hybrid Search: kết hợp BM25 cho lexical search và vector cho semantic search. Việc ScyllaDB bổ sung BM25 vào hệ thống phân tán C++ siêu nhanh của mình giúp doanh nghiệp không phải duy trì thêm cụm Elasticsearch riêng biệt bên cạnh database chính. Đây là kiến trúc tinh gọn giúp cắt giảm đáng kể độ trễ và chi phí hạ tầng RAG.

PlanPool: Khắc phục rủi ro agent Text-to-SQL tự suy đoán ngầm khi thiếu thông tin

Nhóm nghiên cứu công bố bài báo và hệ thống PlanPool, chỉ ra thực trạng đáng báo động khi các agent Text-to-SQL hiện đại thường tự đưa ra các giả định ngầm thiếu căn cứ để sinh câu truy vấn thực thi được.

💡 Cảnh báo về 'cái bẫy đúng cú pháp nhưng sai bản chất', đưa ra cơ chế quản lý câu hỏi làm rõ có thể cập nhật linh hoạt để bảo vệ tính toàn vẹn dữ liệu.

📅 06/10🔗 Website
  • Vạch rõ hiện tượng agent tự đưa ra giả định ngầm không được kiểm chứng
  • Tạo bể câu hỏi làm rõ có khả năng biến đổi linh hoạt
  • Đảm bảo tính minh bạch và có thể kiểm toán của truy vấn SQL
  • Giảm thiểu rủi ro sai lệch số liệu tài chính do ngộ nhận
ARXIV2610.02739FRAMEWORKPlanPoolRISKUnderspecificationMETHODClarification Pool

Đây là một nghiên cứu chạm đúng vào thực tế triển khai AI trong phân tích dữ liệu. Một agent có thể sinh ra câu lệnh SQL chạy trơn tru không lỗi cú pháp, nhưng kết quả doanh thu tính ra có thể đã ngầm loại bỏ khách hàng hoàn tiền chỉ vì model 'tự suy đoán' như vậy. Trong tài chính hay vận hành, những giả định ngầm này có thể dẫn tới quyết định sai lầm tiền tỷ. PlanPool chứng minh rằng một agent tốt không phải là agent vội vã trả lời ngay, mà là agent biết khi nào thông tin bị thiếu và có cơ chế lưu trữ, làm rõ các giả định một cách công khai.

🔥 TOP 4 TUẦN NÀYSnowflake đưa công cụ Code Execution cho Cortex Agents lên GA

Snowflake chính thức đưa công cụ Code Execution lên GA cho Cortex Agents, cho phép agent tự động tạo và chạy mã Python trong sandbox an toàn để giải các bài toán toán học và phân tích nâng cao.

💡 Mở rộng năng lực của Cortex Agents vượt ra ngoài các câu lệnh SQL đơn thuần, giúp agent tự lập trình xử lý logic phân tích phức tạp ngay trên dữ liệu có kiểm soát.

📅 05/10🔗 Website
  • Code Execution cho Cortex Agents đạt trạng thái GA
  • Thực thi mã Python an toàn trong sandbox nội bộ Snowflake
  • Hỗ trợ tính toán thống kê, hồi quy và giải thuật logic phức tạp
  • Giữ nguyên ranh giới bảo mật và phân quyền của dữ liệu
STATUSGAENGINEPython SandboxINTEGRATIONCortex AgentsSECURITYIn-perimeter

SQL là ngôn ngữ tuyệt vời cho việc tổng hợp và lọc dữ liệu, nhưng lại rất cồng kềnh khi phải xử lý thuật toán phức tạp, mô phỏng số học hoặc biến đổi chuỗi nhiều bước. Bằng việc cấp quyền Code Execution an toàn lên GA, Snowflake đưa Cortex Agents bước sang một đẳng cấp mới tương tự Code Interpreter của ChatGPT nhưng chạy ngay trong tường lửa doanh nghiệp. Agent có thể truy vấn dữ liệu ra, viết đoạn script Python để phân tích thống kê chuyên sâu rồi trả về kết luận có kiểm toán. Điểm mấu chốt là sandbox này không để rò rỉ dữ liệu ra ngoài, giải tỏa nỗi lo lớn nhất của các giám đốc an ninh thông tin.

HakiCC: Dùng multi-agent LLM tự thiết kế và tối ưu giao thức kiểm soát tương tranh database

Các nhà nghiên cứu đề xuất HakiCC, một hệ thống multi-agent LLM tự động thiết kế, chứng minh tính đúng đắn và tối ưu hóa các giao thức kiểm soát tương tranh cho từng ứng dụng cơ sở dữ liệu.

💡 Đột phá trong việc dùng AI để thiết kế các thành phần lõi sâu nhất của hệ quản trị cơ sở dữ liệu thay vì chỉ viết ứng dụng bề mặt.

📅 05/10🔗 Website
  • Quy trình hai giai đoạn: sinh và kiểm chứng tính conflict-serializability
  • Vòng lặp tiến hóa do LLM dẫn dắt để nâng cao throughput
  • Tự động hóa thiết kế giao thức tương tranh chuyên biệt cho từng workload
  • Mở đường cho kiến trúc cơ sở dữ liệu tự tối ưu hóa lõi
ARXIV2610.00889DOMAINDatabase KernelAPPROACHMulti-Agent LLMGOALConcurrency Control

Trước đây, chúng ta quen thấy AI được dùng để viết câu truy vấn hoặc gợi ý chỉ mục. HakiCC đi sâu hơn hẳn: can thiệp vào tầng lõi kiểm soát tương tranh của database engine. Bằng cách kết hợp khả năng sinh code của LLM với các công cụ kiểm chứng hình thức toán học, hệ thống có thể tạo ra các giao thức khóa hoặc kiểm soát phiên bản tối ưu riêng cho từng đặc thù truy cập của ứng dụng. Đây là minh chứng rõ ràng cho thấy AI đang tiến sâu vào ngành khoa học máy tính hệ thống, hỗ trợ con người giải các bài toán kỹ thuật phức tạp nhất.

📈 Hot trend & Thảo luận cộng đồng

Hacker News tranh luận: Polars 2.0 có đang biến thành một In-Memory OLAP Database?

Đợt phát hành Polars 2.0 kích hoạt cuộc tranh luận sôi nổi trên Hacker News về việc liệu các thư viện DataFrame hiện đại có đang định nghĩa lại khái niệm database OLAP và cạnh tranh trực tiếp với DuckDB hay không.

💡 Phản ánh sự hội tụ công nghệ rõ nét trong cộng đồng kỹ sư dữ liệu: ranh giới giữa thư viện phân tích mã nguồn mở và hệ quản trị cơ sở dữ liệu đang dần biến mất.

📅 07/10🔗 Website
  • Tranh luận gay gắt giữa cộng đồng về bản chất của Polars 2.0
  • So sánh chi tiết ưu nhược điểm giữa Polars và DuckDB
  • Xu hướng chọn Polars làm engine xử lý thay thế hoàn toàn Pandas
  • Bàn thảo về ranh giới giữa DataFrame API và SQL Database
PLATFORMHacker NewsTOPICPolars vs DuckDBCOMMUNITYData EngineeringCONSENSUSHội tụ OLAP

Cuộc tranh luận trên Hacker News phản ánh một thực tế thú vị: khi Polars có streaming engine, spill-to-disk và trình phân tích cú pháp SQL first-class, sự khác biệt giữa nó và DuckDB chủ yếu còn lại ở tầng lưu trữ file và chuẩn ACID. Nhiều kỹ sư nhận xét Polars 2.0 đã đủ tốt để thay thế hoàn toàn Pandas và giải quyết phần lớn nhu cầu phân tích trên máy đơn mà không cần cài đặt thêm database riêng biệt. Đối với các đội ngũ data, thông điệp rút ra rất rõ ràng: hãy chọn công cụ dựa trên giao diện bạn muốn làm việc thay vì quá lo lắng về hiệu năng xử lý thô.

ArrowMetal tăng tốc DataFusion trên GPU Apple Silicon gấp 6,9 đến 28,8 lần mà không đổi SQL

Dự án mã nguồn mở ArrowMetal công bố quy tắc tối ưu cho Apache DataFusion, chuyển tác vụ sắp xếp tập dữ liệu lớn sang GPU của chip Apple Silicon qua Metal API, đạt tốc độ nhanh hơn từ 6,9 đến 28,8 lần.

💡 Mở ra tiềm năng tận dụng bộ nhớ hợp nhất và GPU mạnh mẽ trên máy trạm Mac để xử lý truy vấn dữ liệu cục bộ với chi phí phần cứng sẵn có.

📅 05/10🔗 Website
  • Tận dụng kiến trúc Unified Memory của Apple M-series
  • Tăng tốc tác vụ sort lớn từ 6,9× đến 28,8× trên chip M4 Max
  • Tích hợp dưới dạng optimizer rule trong Apache DataFusion, giữ nguyên câu SQL
  • Mở đường cho phân tích OLAP cục bộ trên GPU máy trạm
SPEEDUP6,9× - 28,8×HARDWAREApple Silicon GPUENGINEApache DataFusionAPIApple Metal

Apple Silicon với kiến trúc bộ nhớ hợp nhất băng thông hàng trăm GB/s giữa CPU và GPU vốn là mỏ vàng chưa được khai thác hết cho các bài toán phân tích dữ liệu. ArrowMetal chứng minh rằng chỉ với một optimizer rule thông minh trong DataFusion, các tác vụ tính toán nặng như sort hàng chục triệu bản ghi có thể tận dụng hàng nghìn nhân GPU mà không tốn công copy dữ liệu qua lại như trên card đồ họa rời. Điều này mang lại trải nghiệm truy vấn siêu nhanh cho các data scientist và engineer chạy thử nghiệm cục bộ trên MacBook trước khi đẩy lên cloud.

Data Engineering Weekly #290: Ghi log quyết định phải ghi cả ngữ cảnh, không chỉ kết quả

Bản tin Data Engineering Weekly số 290 tập trung phân tích bài học về mô hình hóa quyết định trong kỷ nguyên AI: việc kiểm toán đòi hỏi ghi lại toàn bộ trạng thái dữ liệu và ngữ cảnh lúc quyết định, thay vì chỉ lưu kết quả.

💡 Nhắc nhở cộng đồng dữ liệu về một lỗ hổng kiểm toán lớn khi đưa agent và mô hình máy học vào các luồng ra quyết định tự động.

📅 05/10🔗 Website
  • Bàn luận về Decision Modeling và Logging trong hệ thống tự động
  • Nhấn mạnh tầm quan trọng của việc lưu bối cảnh tại thời điểm quyết định
  • Phân tích rủi ro kiểm toán khi chỉ lưu output cuối cùng của model
  • Đề xuất kiến trúc lưu vết hoàn chỉnh phục vụ giải trình
ISSUESố 290TOPICContext LoggingAUTHORAnanth PackkilduraiSCOPEAudit Trail

Khi một mô hình AI hay agent đưa ra quyết định sai lầm như từ chối phê duyệt khoản vay hoặc gán sai danh mục rủi ro, việc bạn có log ghi 'model đã chọn phương án B' là hoàn toàn vô dụng nếu không biết tại thời điểm đó model nhìn thấy dữ liệu gì. Số 290 của Data Engineering Weekly đưa ra quan điểm rất xác đáng: trong kỷ nguyên agentic, data engineering phải xây dựng hạ tầng lưu vết ngữ cảnh. Dữ liệu tính năng, phiên làm việc và các điều kiện kiểm tra cần được gắn kết thành một khối có thể tái lập để phục vụ giải trình.

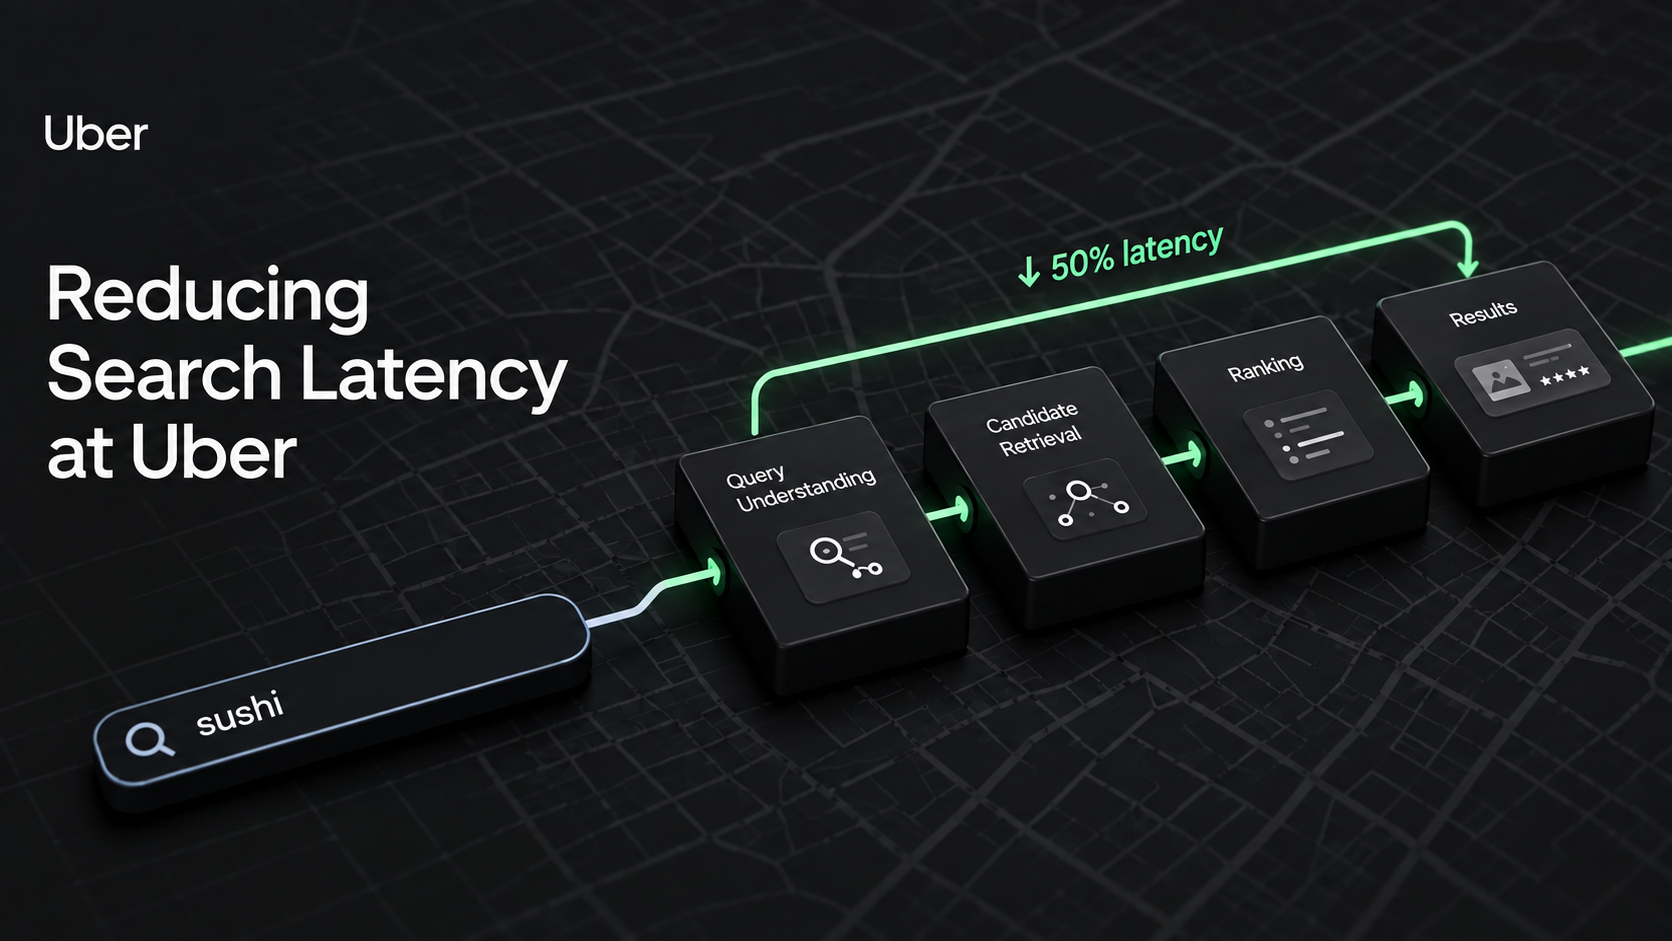
Uber Eats tái cấu trúc search pipeline: cắt đôi latency và loại bỏ tính toán dư thừa

Đội ngũ Uber công bố chi tiết quá trình tái thiết kế pipeline tìm kiếm của Uber Eats, loại bỏ các tác vụ trùng lặp, xử lý song song các bước tính năng và giảm 50% độ trễ phản hồi cho người dùng.

💡 Bài học thực chiến quý giá về việc dọn dẹp nợ kỹ thuật và tối ưu luồng dữ liệu thời gian thực quy mô hàng triệu người dùng.

📅 05/10🔗 Website
  • Cắt giảm 50% độ trễ tìm kiếm cho người dùng cuối
  • Loại bỏ các phép tính trùng lặp tích lũy sau nhiều năm phát triển
  • Chuyển sang thực thi song song và tối ưu phân trang trang đầu
  • Giữ nguyên vẹn chất lượng xếp hạng và gợi ý món ăn
LATENCYGiảm 50%SCALEToàn cầu Uber EatsTEAMUber EngineeringAPPROACHParallel Pipeline

Các pipeline dữ liệu phục vụ tìm kiếm và gợi ý trong doanh nghiệp lớn thường bắt đầu rất gọn gàng, nhưng sau nhiều năm bổ sung tính năng sẽ biến thành một hệ thống rối rắm với vô số bước tính toán dư thừa. Bài học từ Uber Eats cho thấy giá trị của việc dám dừng lại để tái cấu trúc. Thay vì cố gắng mua thêm máy chủ hay nâng cấp phần cứng, đội ngũ kỹ sư đã rà soát lại đồ thị thực thi, chạy song song các bước độc lập và tối ưu kích thước gói tin trang đầu. Đây là tư duy kỹ thuật tinh gọn mà mọi data engineer làm việc với hệ thống tải cao đều nên học hỏi.

Feature Freshness Budgets: Quản lý ngân sách độ tươi dữ liệu cho ML Inference trước stream lag

Nghiên cứu thiết lập khuôn khổ lý thuyết và thực nghiệm cho 'ngân sách độ tươi tính năng', giúp hệ thống suy luận máy học thời gian thực định lượng và xử lý rủi ro suy giảm độ chính xác do trễ luồng streaming.

💡 Đặt nền tảng toán học cho việc xây dựng SLA độ tươi dữ liệu trong các nền tảng feature store hiện đại như Kafka, Redis và PostgreSQL.

📅 05/10🔗 Website
  • Định nghĩa khái niệm ngân sách độ tươi cho từng feature
  • Mô hình hóa tác động của stream lag lên chất lượng dự báo của mô hình
  • Kiểm chứng thực nghiệm trên hạ tầng Kafka, Redis và PostgreSQL
  • Cung cấp ngưỡng suy giảm an toàn cho hệ thống phục vụ
ARXIV2610.02259STACKKafka, Redis, PostgresFOCUSFeature Store LagMETRICFreshness Budget

Trong các bài toán phát hiện gian lận hay định giá động, một feature như số lần quẹt thẻ trong 5 phút qua nếu bị trễ 30 giây do nghẽn hàng đợi Kafka có thể khiến mô hình đưa ra phán đoán sai lầm hoàn toàn. Nghiên cứu này đưa ra phương pháp định lượng ranh giới trễ chấp nhận được. Nhờ đó, hệ thống phục vụ suy luận có thể chủ động chuyển sang kịch bản dự phòng an toàn khi độ tươi vượt quá ngân sách cho phép. Đây là kiến thức chuyên sâu hữu ích cho các kỹ sư đang vận hành nền tảng MLOps và feature store thời gian thực.

🏢 Ngành & Doanh nghiệp

Snowflake đưa Agentic Marketplace Discovery vào Public Preview

Snowflake giới thiệu Agentic Marketplace Discovery cho phép các tác tử AI tự động tìm kiếm, đánh giá và đề xuất tích hợp các bộ dữ liệu bên thứ ba từ Snowflake Marketplace vào bài toán phân tích.

💡 Đưa thị trường dữ liệu từ chỗ chỉ phục vụ con người tìm kiếm bằng tay sang mô hình machine-to-machine, nơi agent tự làm phong phú dữ liệu doanh nghiệp.

📅 09/10🔗 Website
  • Cho phép agent tự động khám phá dữ liệu trên Marketplace
  • Phân tích ngữ cảnh bài toán để gợi ý dataset bên thứ ba phù hợp
  • Đẩy mạnh giao dịch dữ liệu tự động giữa các tổ chức
  • Mở rộng hệ sinh thái ứng dụng dựa trên dữ liệu
STATUSPublic PreviewTARGETSnowflake MarketplaceCAPABILITYAgent DiscoveryMODELAutonomous Agent

Thị trường dữ liệu trước đây thường gặp rào cản lớn về mức độ chấp nhận vì con người không có thời gian duyệt qua hàng nghìn bộ dữ liệu để tìm thứ mình cần. Bằng việc mở API cho AI agent tự khám phá, Snowflake mở ra một kênh phân phối hoàn toàn mới. Một agent khi được giao bài toán dự báo nhu cầu thị trường có thể tự nhận ra mình đang thiếu dữ liệu thời tiết hay kinh tế vĩ mô, tự tìm kiếm trên Marketplace và trình đề xuất cho con người duyệt mua. Đây là tương lai rõ ràng của nền kinh tế dữ liệu tự trị.

🔥 TOP 5 TUẦN NÀYAccenture và Dell Technologies thành lập nhóm kinh doanh chung đẩy mạnh Private AI

Accenture và Dell Technologies mở rộng hợp tác 20 năm, thành lập Accenture Dell Business Group để cung cấp giải pháp Private AI trọn gói on-premise và hybrid cloud cho doanh nghiệp lớn, cam kết đào tạo hơn 3.000 chuyên gia.

💡 Khẳng định xu hướng dịch chuyển mạnh mẽ của các doanh nghiệp quy mô lớn: đưa AI về gần dữ liệu nội bộ trên hạ tầng riêng để kiểm soát chi phí và bảo mật tuyệt đối.

📅 08/10🔗 Website
  • Thành lập Accenture Dell Business Group phục vụ Private AI
  • Tập trung vào các ngành nhạy cảm: tài chính, y tế, sản xuất
  • Đào tạo hơn 3.000 chuyên gia tư vấn trên hệ sinh thái Dell AI
  • Triển khai kiến trúc tham chiếu cho mô hình mở và Agentic AI
PARTNERSAccenture & DellTARGETPrivate AI on-premiseWORKFORCE3.000+ chuyên giaTIMELINE20 năm hợp tác

Sau làn sóng đầu tiên ồ ạt thử nghiệm AI trên public cloud, nhiều tập đoàn lớn trong các lĩnh vực ngân hàng, chăm sóc sức khỏe và sản xuất bắt đầu giật mình trước hóa đơn suy luận tăng phi mã và rủi ro rò rỉ dữ liệu mật. Liên minh giữa tập đoàn tư vấn hàng đầu thế giới và ông lớn phần cứng hạ tầng là câu trả lời rõ ràng cho bài toán này. Họ mang tới giải pháp chìa khóa trao tay giúp doanh nghiệp chạy mô hình mã nguồn mở trên máy chủ nội bộ với độ bảo mật cao nhất. Điều này củng cố một nguyên lý căn bản của ngành dữ liệu: di chuyển mô hình đến chỗ dữ liệu luôn rẻ hơn và an toàn hơn việc di chuyển dữ liệu đến chỗ mô hình.

Scality ra mắt AI Inference Factory: giải pháp On-Premise chuyển KV-Cache sang Object Storage

Scality ra mắt giải pháp AI Inference Factory mã nguồn mở, tích hợp tầng lưu trữ AI Data Infrastructure cho phép offload bộ nhớ KV-cache từ GPU sang object storage hiệu năng cao, giúp mở rộng ngữ cảnh suy luận mà không bị nghẽn RAM GPU.

💡 Giải quyết điểm nghẽn chi phí lớn nhất của các ứng dụng agentic AI: bộ nhớ VRAM đắt đỏ khi xử lý chuỗi hội thoại dài và context lớn.

📅 08/10🔗 Website
  • Stack phần mềm mã nguồn mở cho inference nội bộ doanh nghiệp
  • Tách biệt pha prefill và decode để scale độc lập
  • Lưu trữ và truy xuất KV-cache trên object storage hiệu năng cao
  • Giúp đóng băng phiên bản mô hình mở để ứng dụng chạy ổn định
LAUNCH08/10/2026INNOVATIONKV-cache offloadVENDORScalitySTACKOpen-code software

Khi các ứng dụng agentic AI cần đọc tài liệu hàng trăm nghìn token hoặc duy trì lịch sử hội thoại nhiều bước, bộ nhớ HBM trên GPU trở thành nút thắt đắt đỏ nhất. Mua thêm GPU chỉ để chứa bộ nhớ đệm KV là phương án cực kỳ tốn kém. Kiến trúc của Scality khéo léo bóc tách KV-cache đẩy sang object storage tốc độ cao, giải phóng bộ nhớ GPU cho việc tính toán thuần túy. Hơn nữa, việc cho phép doanh nghiệp đóng băng phiên bản mô hình on-premise giúp hệ thống vận hành ổn định, không lo nhà cung cấp cloud tự ý đổi checkpoint ngầm.

Snowflake mở GA kết nối Zero-Copy với Workday Data Cloud

Snowflake chính thức đưa kết nối chia sẻ dữ liệu không sao chép với Workday Data Cloud lên GA, cho phép doanh nghiệp truy vấn dữ liệu nhân sự và tài chính tức thời mà không cần xây dựng pipeline ETL.

💡 Giảm thiểu độ trễ dữ liệu và loại bỏ rủi ro bảo mật phát sinh khi sao chép dữ liệu nhân sự nhạy cảm ra nhiều kho trung gian.

📅 07/10🔗 Website
  • Kết nối chia sẻ dữ liệu zero-copy đạt trạng thái GA
  • Truy cập dữ liệu Workday trực tiếp từ tài khoản Snowflake
  • Hết cảnh phải duy trì pipeline ETL sao chép dữ liệu nặng nề
  • Đảm bảo an toàn tuyệt đối cho dữ liệu nhân sự nhạy cảm
STATUSGAPARTNERWorkday Data CloudARCHITECTUREZero-copy sharingSECURITYPhân quyền tập trung

Dữ liệu nhân sự và chi phí từ Workday là nguồn dữ liệu tối mật nhưng lại cực kỳ cần thiết cho các báo cáo phân tích hiệu quả kinh doanh. Việc dựng pipeline ETL truyền thống để kéo dữ liệu này về data warehouse thường mất nhiều tuần phê duyệt bảo mật và tiềm ẩn nguy cơ lộ thông tin cá nhân. Tính năng zero-copy integration giúp Snowflake truy vấn trực tiếp bảng Workday dưới quyền quản trị thống nhất. Dữ liệu không bị nhân bản, quyền hạn được kế thừa và báo cáo luôn phản ánh số liệu mới nhất. Đây là hình mẫu lý tưởng cho việc tích hợp SaaS data vào hiện đại hóa doanh nghiệp.