🎬 Video recap tuần — các tin nóng nhất

📌 TỔNG QUAN TUẦN NÀY

Tuần 38 là tuần AI bắt đầu tham gia vào việc tạo ra chính nó. Anthropic công bố chỉ số cho thấy Claude đang dẫn dắt 26 phần trăm khối lượng nghiên cứu và phát triển của chính công ty, tăng từ dưới 1 phần trăm hồi tháng 2. Cùng lúc Google ra Gemini 3.8 Live và Live Extended Thinking cho hội thoại thời gian thực, Anthropic gộp Claude chat với Cowork rồi thêm Docs và Slides, còn Claude Code Projects học cách điều phối nhiều luồng agent chạy song song trên cloud. Mặt kia của tuần là an toàn và niềm tin: OpenAI công bố sáu ca hành vi lệch chuẩn kèm khung báo cáo mới, 404 Media tiết lộ hàng trăm người được thuê để đọc prompt thật của người dùng, và khảo sát Pew ở 37 nước cho thấy đa số tin AI sẽ lấy đi việc làm. Phần cứng cũng lập mốc khi Vera Rubin NVL72 lần đầu lên bảng MLPerf với throughput gấp 3,7 lần thế hệ trước.

T2 14/096 tinT3 15/094 tinT4 16/0910 tinT5 17/097 tinT6 18/090 tinT7 19/090 tinCN 20/090 tin

🚀 Mô hình & Sản phẩm mới

OpenAI ra Astra for Law: GPT-6 Astra ghép chỉ mục tra cứu pháp lý hơn 230 triệu URL

Ngày 17/09 OpenAI giới thiệu Astra for Law, một cấu hình của GPT-6 Astra gắn với chỉ mục tra cứu hơn 230 triệu URL gồm án lệ, luật, quy định và phán quyết hành chính của Mỹ, cập nhật hằng ngày. Bản này đạt 54 phần trăm trên 200 câu hỏi của bộ Legal Research Bench do Vals AI chấm, phát trước cho một số hãng luật qua Trusted Access.

💡 Đây là lần đầu OpenAI đóng gói model biên giới thành một bản chuyên ngành có kho dữ liệu riêng thay vì bán model chung. Mô hình model nền cộng kho tri thức ngành chính là thứ các công ty dịch vụ ở Việt Nam có thể sao chép cho luật, kế toán hay bảo hiểm.

📅 17/09🔗 Website
  • Chỉ mục pháp lý riêng trải hơn 230 triệu URL, bổ sung hằng ngày
  • Bao phủ án lệ, luật, quy định, quy tắc toà và phán quyết hành chính Mỹ
  • Đạt 54 phần trăm trên 200 câu Legal Research Bench của Vals AI
  • Phát qua Trusted Access trong ChatGPT và Codex, API theo sau
  • Harvey và Legora nằm trong nhóm khách API xây tiếp lên trên
MODELGPT-6 AstraINDEX230 triệu URLBENCH54% Legal Research BenchKÊNHTrusted AccessNGÀY17/09/2026

Điểm đáng học ở đây không phải là model, mà là cách đóng gói. OpenAI không huấn luyện lại gì cả, họ lấy model sẵn có rồi bọc quanh nó một chỉ mục dữ liệu ngành, một bộ chỉ dẫn viết theo văn phong ngành và một lớp kiểm soát truy cập. Đó chính xác là kiến trúc RAG cấp doanh nghiệp mà Đức vẫn dựng cho khách, chỉ khác quy mô. Con số 54 phần trăm cũng đáng nói: nó không phải điểm để khoe, nó là lời thừa nhận rằng gần một nửa câu hỏi pháp lý vẫn cần luật sư kiểm lại. Với doanh nghiệp Việt, bài học thực dụng là đừng chờ ai đó ra bản chuyên ngành tiếng Việt cho mình. Kho văn bản pháp luật, quy trình nội bộ và hợp đồng cũ của công ty bạn đã là chỉ mục rồi, thứ thiếu là kỷ luật làm sạch dữ liệu và một lớp đánh giá trung thực. Ai làm được lớp đánh giá đó trước sẽ bán được dịch vụ, chứ không phải ai gọi được API xịn nhất.

Anthropic gộp Claude chat và Cowork làm một, ra mắt Claude Docs và Claude Slides

Ngày 16/09 Anthropic hợp nhất ba giao diện Chat, Cowork và Design thành một Claude duy nhất tự định tuyến yêu cầu, không còn phải chuyển tab. Kèm theo là Claude Docs và Claude Slides bản beta, xuất thẳng ra Google Docs, Word, PowerPoint và PDF ngay trong hội thoại.

💡 Xuất được tài liệu và bản trình bày ngay trong khung chat cắt bỏ bước copy dán vốn ngốn thời gian nhất của dân văn phòng. Với đội tư vấn và đào tạo, đây là thứ đổi cách làm sản phẩm bàn giao chứ không chỉ là tính năng thêm.

📅 16/09🔗 Website
  • Ba giao diện Chat, Cowork và Design gộp thành một, Claude tự định tuyến
  • Claude Docs cho soạn và sửa tài liệu ngay trong hội thoại
  • Claude Slides sinh bản trình bày, sửa trực tiếp hoặc trình chiếu
  • Xuất native ra Google Docs, Word, PowerPoint và PDF
  • Mở trước cho Pro và Max trên web, desktop và mobile; Enterprise báo trước ít nhất 30 ngày
BETADocs + SlidesXUẤTDocs/Word/PPT/PDFGÓI ĐẦUPro & MaxENTERPRISEbáo trước 30 ngàyNGÀY16/09/2026

Đức thử ngay hôm nó ra, và thứ đáng tiền không phải Slides đẹp hay không, mà là việc bỏ được cái bước chuyển tab. Trước đó mỗi lần muốn biến một phân tích thành slide là phải mở công cụ khác, dán lại nội dung, mất ngữ cảnh, rồi sửa tay. Gộp làm một nghĩa là ngữ cảnh không rơi. Nhưng nói thẳng luôn: bản trình bày do máy sinh ra vẫn ở mức khung sườn, không phải bản gửi khách. Ai làm tư vấn sẽ vẫn phải bỏ khoảng một phần ba công để sửa cấu trúc câu chuyện, vì cấu trúc mới là phần khách trả tiền. Chỗ nó ăn tiền ngay là các tài liệu nội bộ: biên bản, tóm tắt dự án, tài liệu đào tạo, báo cáo tuần. Với team nhỏ ở Việt Nam, đó là vài giờ mỗi tuần lấy lại được mà không cần đổi quy trình gì.

🔥 TOP 2 TUẦN NÀY Google ra Gemini 3.8 Live và 3.8 Live Extended Thinking: hội thoại vừa nói vừa nghĩ

Ngày 15/09 Google công bố cặp model hội thoại trực tiếp mới đạt 97,7 phần trăm trên Big Bench Audio. Bản Live nhắm quy mô và chi phí, bản Live Extended Thinking dành cho tác vụ phức tạp cần suy luận nhiều bước và có thể xử lý việc nền mà không cắt mạch hội thoại.

💡 Giọng nói là giao diện mà người dùng Việt Nam tiếp cận AI nhanh nhất, và một model biết vừa nói vừa chạy tác vụ nền sẽ mở đường cho tổng đài, trợ lý bán hàng và chăm sóc khách hàng nội địa.

📅 15/09🔗 Website
  • Hai bản: Live cho quy mô và chi phí, Live Extended Thinking cho tác vụ phức tạp
  • Đạt 97,7 phần trăm trên Big Bench Audio
  • Có mặt trong Gemini API và Google AI Studio cho lập trình viên
  • Gemini Enterprise ở dạng private preview cho doanh nghiệp
  • Live mở cho mọi người trong Search Live; Extended Thinking vào Gemini Live, Docs, Gmail và Keep
ĐIỂM97,7% Big Bench AudioBẢNLive / Live Extended ThinkingDEVGemini API + AI StudioNGƯỜI DÙNGSearch Live, Gemini LiveNGÀY15/09/2026

Con số 97,7 phần trăm nghe to nhưng đó không phải phần quan trọng. Phần quan trọng là câu nói model xử lý việc nền mà không cắt mạch hội thoại. Ai từng dựng bot thoại đều biết cái chết của trải nghiệm nằm ở khoảng lặng: người dùng hỏi, bot phải gọi API, và ba giây im lặng đủ để người ta cúp máy. Nếu model thật sự vừa nói chuyện vừa chạy tool ở nền, bài toán đó được giải ở tầng model chứ không phải tầng ứng dụng. Theo Đức, đây là thứ đáng thử nhất cho các đội làm tổng đài và bán hàng ở Việt Nam trong quý tới. Nhưng cẩn trọng hai chỗ: tiếng Việt chưa được nêu tên trong thông báo, và chi phí của bản Extended Thinking chắc chắn không rẻ như bản Live. Cách làm đúng là định tuyến, dùng bản Live cho phần lớn lượt thoại và chỉ đẩy sang Extended Thinking khi câu hỏi thật sự cần suy luận.

🔥 TOP 4 TUẦN NÀY TypeSafe ra Jev, System One Model không sinh chữ mà chỉ trả quyết định có kiểu

Ngày 15/09 startup TypeSafe ở San Francisco công bố Jev, model nhận đầu vào tự do và trả về một quyết định có kiểu, là lựa chọn, điểm số hoặc xác suất đúng sai, trong đúng một lượt truyền song song thay vì sinh từng token. Hãng công bố giá 0,042 USD cho một triệu token đầu vào, output miễn phí, và nhanh hơn model biên giới nhỏ từ 40 tới 200 lần.

💡 Rất nhiều chỗ trong hệ thống thực chỉ cần một quyết định nhỏ như phân loại ticket, định tuyến hay chấm điểm, nhưng đang bị tính tiền như đang viết văn. Tách phần đó ra một model rẻ hơn hai bậc là cách hạ chi phí AI nhanh nhất mà không phải đổi kiến trúc.

📅 15/09🔗 Website
  • Không sinh văn bản, chỉ trả quyết định có kiểu trong một lượt truyền song song
  • Nhanh hơn model biên giới nhỏ từ 40 tới 200 lần theo công bố của hãng
  • Giá 0,042 USD cho một triệu token đầu vào, output không tính tiền
  • Về mặt thiết kế không thể ảo giác hay sinh sai kiểu dữ liệu
  • Chủ đề nóng nhất Hacker News trong ngày với gần 1.800 điểm
GIÁ0,042 USD / 1M token vàoTỐC ĐỘ40-200xOUTPUTmiễn phíHN~1.800 điểmNGÀY15/09/2026

Cái tên System One lấy từ Kahneman, hệ thống một là phản xạ nhanh, hệ thống hai là suy nghĩ chậm. Ý tưởng đơn giản tới mức bực mình: phần lớn lời gọi LLM trong hệ thống doanh nghiệp không cần văn, nó cần một nhãn. Đức đếm thử trong các pipeline đang chạy thì phần lớn lời gọi chỉ để phân loại, định tuyến hoặc chấm điểm liên quan hay không. Mỗi lời gọi đó đang trả tiền cho một cỗ máy sinh văn bản. Nếu con số của TypeSafe đúng, thay riêng phần này thôi đã cắt được phần lớn hoá đơn mà không đụng gì tới phần thật sự cần suy luận. Nói rõ phần cần cẩn trọng: đây là công bố của chính hãng, chưa có bên thứ ba đo lại, và cộng đồng Hacker News đã đẩy mạnh vào phần marketing chứ không phải phần kỹ thuật. Việc nên làm là đo trên chính dữ liệu của mình bằng một tập nhỏ trước, đừng thay cả pipeline vì một dòng tiêu đề.

ShengShu ra Vidu S2: sinh và chỉnh sửa video thời gian thực ở 720p

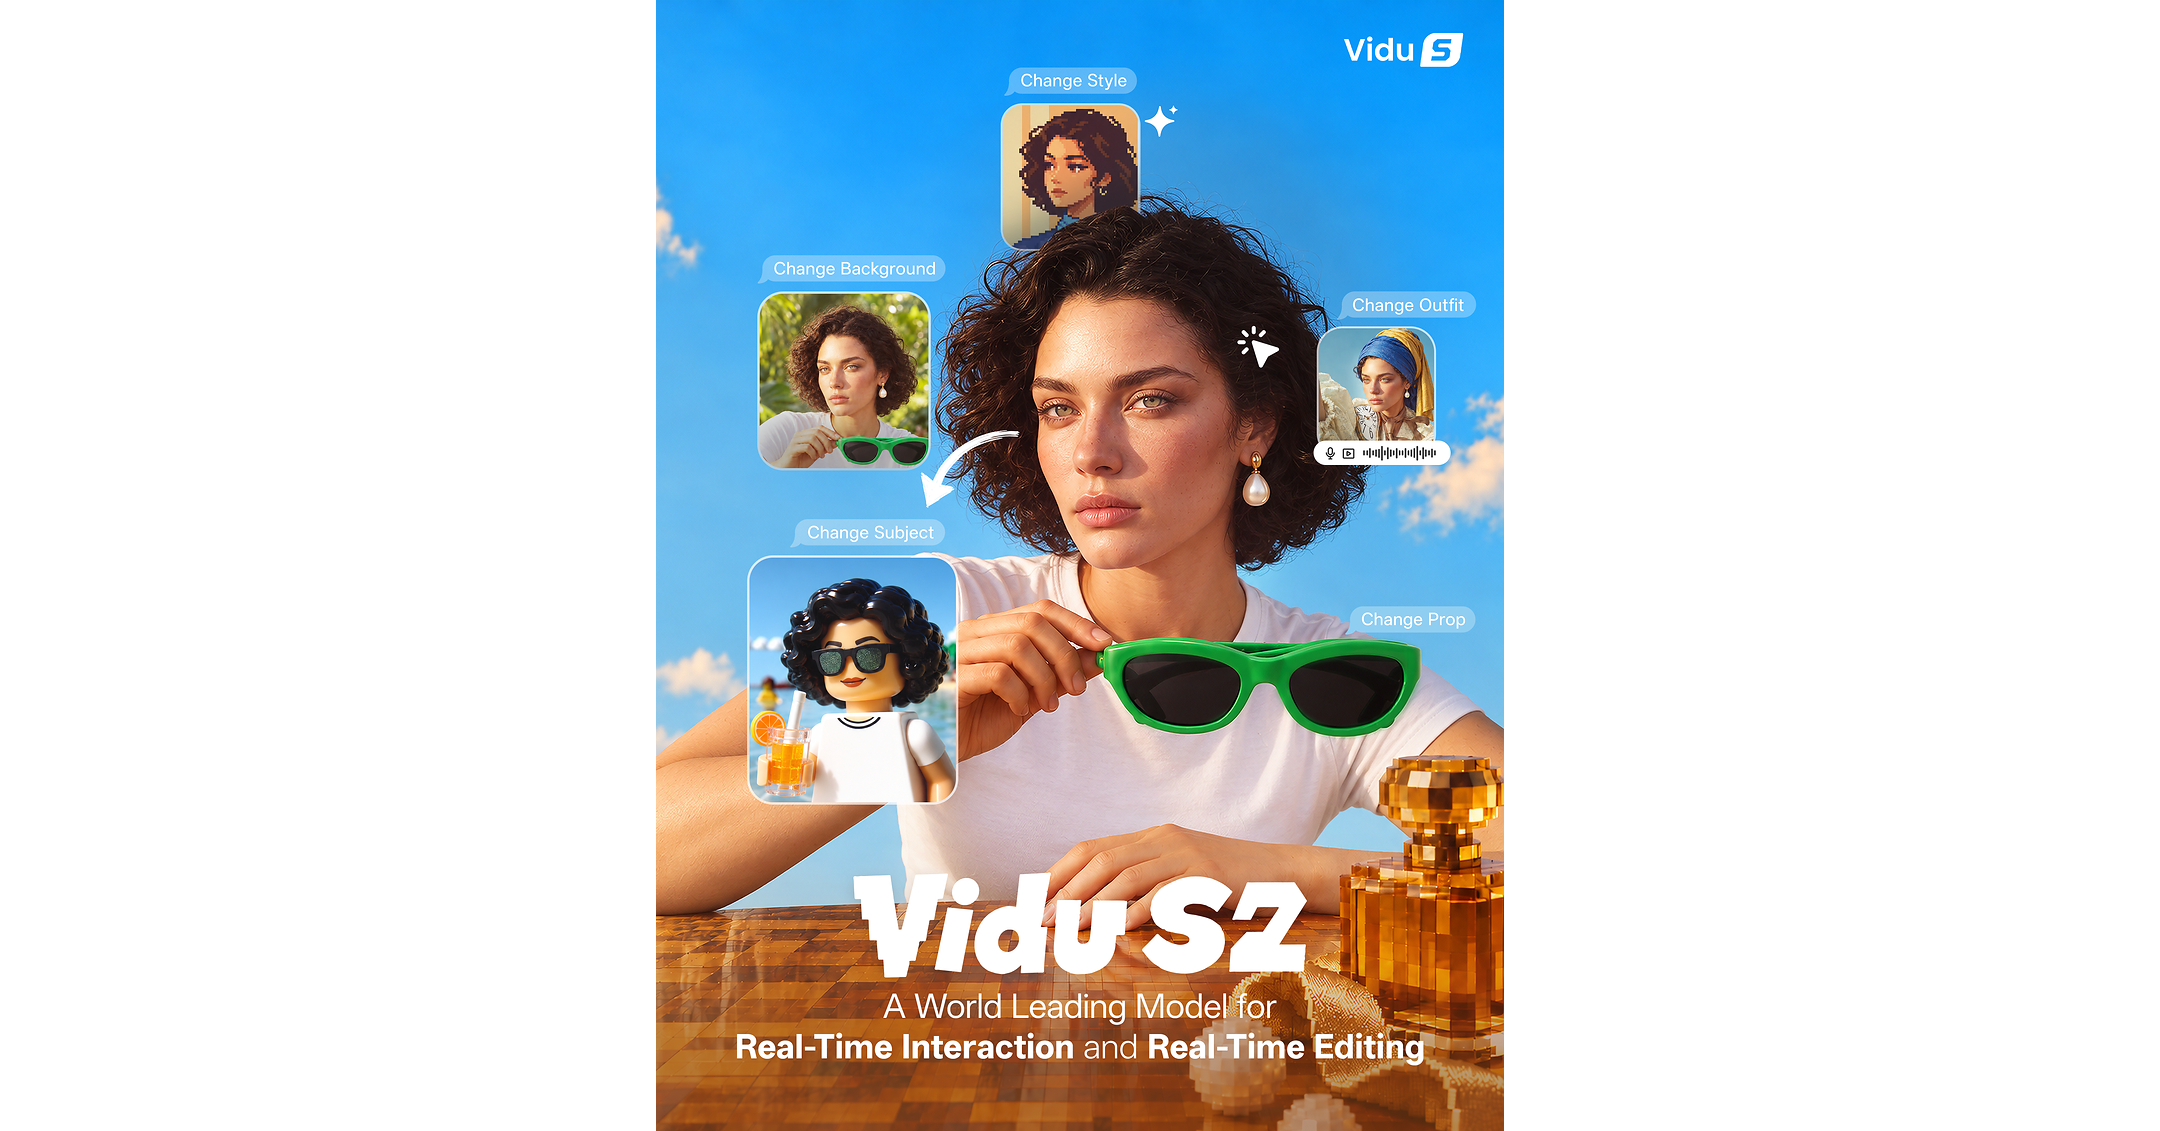
Ngày 15/09 ShengShu Technology cùng Đại học Thanh Hoa công bố Vidu S2 gồm hai phần: S2-Avatar sinh nhân vật số 720p ở 25 tới 42 khung hình mỗi giây và nhận ảnh tham chiếu mới ngay giữa luồng, và S2-Editing chỉnh sửa luồng video trực tiếp như đổi phong cách, thay trang phục, thay nhân vật hay nền.

💡 Video thời gian thực là mảnh ghép cuối cho livestream bán hàng và người dẫn ảo, lĩnh vực mà thị trường Việt Nam đang tiêu tiền thật. Chỉnh được ngay trên luồng nghĩa là không còn khâu render chờ.

📅 15/09🔗 Website
  • S2-Avatar sinh nhân vật số 720p ở 25 tới 42 khung hình mỗi giây
  • Nhận ảnh tham chiếu mới bất kỳ lúc nào trong luồng đang chạy
  • S2-Editing đổi phong cách, thay đồ, thay nhân vật và nền ngay trên luồng
  • Bám chỉ dẫn tốt hơn bản S1, làm được cả động tác như nhảy
  • Có bản demo chơi thử trực tuyến kèm tài liệu kỹ thuật và API
ĐỘ PHÂN GIẢI720pFPS25-42PHẦNAvatar + EditingĐƠN VỊShengShu + Thanh HoaNGÀY15/09/2026

Livestream bán hàng ở Việt Nam là một ngành thật, tiêu tiền thật, và nút thắt lớn nhất của nó là con người phải ngồi trước camera nhiều giờ. Mọi thử nghiệm người dẫn ảo trước đây vấp đúng một chỗ: độ trễ. Sinh video theo lô thì đẹp nhưng không tương tác được với bình luận, mà không tương tác được thì không phải livestream. 25 tới 42 khung hình mỗi giây ở 720p là mốc đầu tiên đủ để nói chuyện được. Phần Đức thấy thú vị hơn là S2-Editing: đổi trang phục và nền ngay trên luồng nghĩa là một buổi live có thể thay set mà không dựng lại studio. Nhưng đừng vội mừng. Chất lượng ở 720p vẫn là mức xem trên điện thoại, chi phí GPU cho luồng thời gian thực không rẻ, và câu chuyện pháp lý về hình ảnh người thật sẽ đến rất nhanh sau khi công cụ đủ tốt. Ai định làm thì nên chuẩn bị phần đồng ý sử dụng hình ảnh trước khi chuẩn bị phần kỹ thuật.

Apple phát hành iOS 27 kèm Siri AI chạy trên Gemini, bản beta phải xếp hàng

Ngày 14/09 Apple phát hành iOS 27 cùng bản beta của Siri AI, trợ lý được dựng lại trên model Gemini của Google kết hợp Foundation Models của chính Apple. Siri AI mới hiện chỉ nói tiếng Anh, người dùng phải tự bật trong phần cài đặt và có thể phải chờ danh sách đợi; iPhone ở châu Âu chưa có.

💡 Đây là lần đầu Apple công khai đặt lõi trợ lý của mình lên model của một đối thủ trực tiếp. Nó xác nhận rằng ngay cả hãng giàu nhất ngành cũng chọn mua năng lực model thay vì tự làm bằng mọi giá.

📅 14/09🔗 Website
  • Siri AI dựng trên Gemini của Google cộng Foundation Models của Apple
  • Phát hành cùng iPadOS 27, macOS 27, watchOS 27, visionOS 27 và tvOS 27
  • Chỉ hỗ trợ tiếng Anh ở giai đoạn đầu, phải tự bật trong cài đặt
  • Có danh sách chờ, chưa mở cho iPhone tại châu Âu
  • Yêu cầu iPhone 16 trở lên, iPhone 15 Pro, hoặc máy Mac và iPad chip M1 trở lên
LÕIGemini + Foundation ModelsNGÔN NGỮtiếng AnhTRẠNG THÁIbeta, có waitlistEUchưa cóNGÀY14/09/2026

Chuyện Apple mua model của Google từng là tin đồn từ đầu năm, giờ nó nằm trong bản iOS trên máy người dùng. Theo Đức, đây là tín hiệu rõ nhất cho một điều mà nhiều lãnh đạo doanh nghiệp Việt vẫn chưa chịu chấp nhận: tự huấn luyện model nền không phải lợi thế cạnh tranh của bạn, trừ khi bạn là một trong vài công ty trên thế giới. Apple có tiền, có chip, có dữ liệu, có cả đội nghiên cứu, mà vẫn chọn mua. Lợi thế của Apple nằm ở chỗ khác, ở phân phối, ở tích hợp hệ điều hành, ở quyền riêng tư trên thiết bị. Câu hỏi đúng cho doanh nghiệp là bạn sở hữu cái gì mà người khác không copy được, dữ liệu riêng hay quy trình riêng hay quan hệ khách hàng. Model là thứ đi thuê. Còn chi tiết đáng chú ý nhất với người Việt là tiếng Anh trước, châu Âu sau, và chúng ta thì chưa có tên trong danh sách nào cả.

🛠️ Công cụ & Framework

Claude Code Projects được thiết kế lại: một điều phối viên quản nhiều luồng agent song song

Ngày 17/09 Anthropic phát hành bản beta Projects mới cho Claude Code, trong đó Claude bóc tách yêu cầu, giao việc, điều phối các luồng chạy song song rồi ghép kết quả. Mỗi luồng là một phiên cloud riêng làm trên nhánh và bản sao repo của nó; khi hai luồng đụng cùng đoạn code thì xử lý như merge conflict bình thường.

💡 Đây là bước chuyển từ một agent gõ code cho bạn sang một đội agent có người điều phối. Với đội nhỏ, mô hình nhánh riêng cho từng luồng là cách duy nhất khiến chạy song song không biến thành đống đổ nát.

📅 17/09🔗 Website
  • Claude bóc tách yêu cầu, giao việc, điều phối luồng rồi ghép kết quả cuối
  • Mỗi luồng là một phiên cloud riêng, có nhánh và bản sao repo riêng
  • Xung đột giữa các luồng xử lý như merge conflict của pull request
  • Các luồng dùng chung bộ nhớ và thư viện file, artifact của project
  • Beta mở trước cho một số người dùng Pro và Max dùng phiên cloud
TRẠNG THÁIbetaGÓIPro & MaxĐƠN VỊ LUỒNG1 nhánh + 1 bản repoXUNG ĐỘTmerge conflictNGÀY17/09/2026

Chạy nhiều agent song song trên cùng một repo là chuyện ai cũng từng thử và ai cũng từng bỏ, vì chúng ghi đè lên nhau. Cách giải ở đây không có gì mới với người làm phần mềm: mỗi luồng một nhánh, đụng nhau thì merge. Cái mới là có một điều phối viên tự bóc việc ra thay vì bạn phải tự chia. Đức đã chạy thử trên một repo thật và rút ra hai điều. Thứ nhất, nó chỉ hiệu quả khi công việc thật sự tách rời được, kiểu tối ưu từng endpoint hay viết test cho từng module; giao một việc đan chéo nhau thì bạn chỉ đổi từ chờ một agent sang chờ năm agent rồi tự gỡ năm merge conflict. Thứ hai, chi phí nhân lên theo số luồng, nên đây không phải chế độ để bật mặc định. Nguyên tắc Đức dùng là chỉ song song hoá khi có thể viết ra bằng một câu rằng mỗi luồng chạm vào file nào. Không viết ra được thì đừng song song.

Xiaomi livestream toàn bộ quá trình RL post-training của MiMo-V2.6

Ngày 17/09 đội MiMo của Xiaomi mở một dashboard công khai phát trực tiếp quá trình reinforcement learning hậu huấn luyện cho hai nhánh Pro và Flash: số bước, đường cong reward, throughput token, chi phí tích luỹ và các sự cố hạ tầng. Mỗi bước lấy 1.568 prompt, lấy mẫu 16 rollout cho mỗi prompt và chạy qua khoảng 2 tỷ token sinh ra.

💡 Chưa phòng lab lớn nào ở Mỹ để lộ chi phí và đường cong reward theo thời gian thực như vậy. Với người đang học RL, đây là tài liệu thực chiến quý hơn bất kỳ bài blog nào.

📅 17/09🔗 Website
  • Dashboard công khai phát trực tiếp hai nhánh Pro và Flash cùng lúc
  • Hiển thị số bước, reward, throughput token, chi phí tích luỹ và sự cố hạ tầng
  • Mỗi bước lấy 1.568 prompt và 16 rollout cho mỗi prompt
  • Khoảng 2 tỷ token sinh ra cho mỗi bước huấn luyện
  • Trộn chung tác vụ code, tổng quát, thị giác, an ninh mạng và chat agent trong một lần chạy
PROMPT/BƯỚC1.568ROLLOUT16 mỗi promptTOKEN/BƯỚC~2 tỷNHÁNHPro + FlashNGÀY17/09/2026

Đây là thứ Đức tiếc là không có sớm hơn hồi đi dạy. Mọi tài liệu về reinforcement learning hậu huấn luyện đều kể lại sau khi mọi thứ xong xuôi, đường cong đã đẹp, sự cố đã bị cắt khỏi bài. Ở đây bạn nhìn thấy cả lúc nó đi ngang, lúc hạ tầng chết, và chi phí cộng dồn theo từng giờ. Riêng con số 1.568 prompt nhân 16 rollout nhân mỗi bước khoảng 2 tỷ token đã đủ để bất kỳ ai định tự làm RL hiểu quy mô tiền mình đang nói tới. Một chi tiết kỹ thuật đáng chú ý: họ trộn code, thị giác, an ninh mạng và chat agent vào chung một lần chạy thay vì huấn luyện riêng từng miền. Đó là lựa chọn ngược với trực giác thông thường và nếu nó ra kết quả tốt thì sẽ đổi cách nhiều đội thiết kế giai đoạn hậu huấn luyện. Dùng nó làm tài liệu giảng dạy thì tuyệt, nhưng nhớ rằng đây vẫn là kênh truyền thông của một hãng, và thứ họ chọn để hiện lên màn hình cũng là một quyết định.

Mistral bắt tay Mozilla: Mistral Small 4 vào thẳng Smart Window của Firefox

Ngày 16/09 Mozilla công bố đưa Mistral Small 4 thành một lựa chọn model trong bản beta Smart Window của Firefox, thay vì khoá trải nghiệm vào một nhà cung cấp duy nhất. Mozilla cam kết không bán dữ liệu cá nhân và không dùng hội thoại để huấn luyện; đợt đầu mở ở Mỹ, Canada và Pháp, Anh và Đức theo sau trong năm nay.

💡 Đây là ví dụ hiếm hoi của trình duyệt cho người dùng chọn model thay vì áp đặt. Nếu mô hình này lan ra, câu hỏi model nào chạy trong trình duyệt của tôi sẽ thành một lựa chọn như chọn công cụ tìm kiếm.

📅 16/09🔗 Website
  • Mistral Small 4 thành một lựa chọn model trong Smart Window beta
  • Smart Window tóm tắt tìm kiếm phức tạp và tra lại thứ đã xem theo các tab
  • Mozilla cam kết không bán dữ liệu và không dùng hội thoại để huấn luyện
  • Đợt đầu mở tại Mỹ, Canada và Pháp; Anh và Đức theo sau
  • Chủ đề đứng đầu Hacker News với hơn 500 điểm và gần 190 bình luận
MODELMistral Small 4SẢN PHẨMFirefox Smart WindowTHỊ TRƯỜNGUS, CA, FRHN531 điểmNGÀY16/09/2026

Chuyện trình duyệt cho chọn model nghe nhỏ nhưng nó đụng vào một câu hỏi lớn: ai sở hữu lớp trung gian giữa người dùng và web. Nếu mỗi trình duyệt khoá cứng một model, thì trong năm năm nữa cái thanh địa chỉ sẽ thuộc về ba công ty. Mozilla không đủ sức thắng cuộc đua model, nhưng họ đủ sức giữ cái cửa mở, và đó là vai trò hợp lý nhất còn lại cho một tổ chức phi lợi nhuận. Phần Đức chú ý là chữ đa ngôn ngữ trong thông báo. Mistral vốn mạnh ở các ngôn ngữ ngoài tiếng Anh hơn nhiều model Mỹ cùng cỡ, nên nếu Việt Nam lọt vào danh sách sau thì đây có thể là bản trợ lý duyệt web đầu tiên đọc tiếng Việt ra hồn mà không gửi hội thoại đi huấn luyện. Với doanh nghiệp, bài học là quyền chọn nhà cung cấp phải nằm trong thiết kế ngay từ đầu. Đừng viết code khoá chặt vào một API, vì giá và điều khoản sẽ đổi, luôn luôn đổi.

Google mở early access Home MCP: agent bên thứ ba điều khiển được thiết bị Nest

Ngày 16/09 Google mở bản early access cho máy chủ Home MCP, cho phép các agent bên ngoài như Claude, ChatGPT, OpenClaw hay Antigravity điều khiển thiết bị Nest và Matter, tóm tắt camera, xem hoạt động và dựng dashboard riêng. Quyền truy cập gắn với gói Google Home Premium Advanced 20 USD mỗi tháng và phải tự dựng một project trên Google Cloud, còn các hành động nhạy cảm như mở khoá cửa vẫn bị chặn.

💡 MCP đang biến từ chuẩn của giới lập trình thành hạ tầng tiêu dùng. Đáng chú ý hơn cả là việc Google chặn cứng nhóm hành động nhạy cảm, một ranh giới mà mọi đội làm agent nên học.

📅 16/09🔗 Website
  • Agent bên thứ ba gồm Claude, ChatGPT, OpenClaw và Antigravity đều kết nối được
  • Điều khiển thiết bị Nest và Matter, tóm tắt camera, dựng dashboard riêng
  • Yêu cầu gói Google Home Premium Advanced 20 USD mỗi tháng
  • Phải tự tạo một project Google Cloud rồi cấp quyền MCP
  • Hành động nhạy cảm như mở khoá cửa vẫn bị chặn, đợt đầu chỉ mở ở Mỹ
CHUẨNMCPGIÁ20 USD/thángTHỊ TRƯỜNGMỹCHẶNmở khoá cửaNGÀY16/09/2026

Một năm trước MCP còn là thứ dân làm agent bàn với nhau, giờ nó là cái Google dùng để mở nhà bạn cho phần mềm bên ngoài. Đó là tốc độ mà một chuẩn kỹ thuật hiếm khi đạt được. Nhưng phần đáng học nhất lại là phần họ không cho làm. Google cho agent xem camera, chỉnh nhiệt độ, bật đèn, nhưng chặn mở khoá cửa. Đây chính xác là nguyên tắc đặc quyền tối thiểu áp vào đời thực: không phải mọi thứ API làm được đều nên cho agent làm. Đức nói điều này với mọi khách đang dựng agent nội bộ, và phần lớn đều bỏ qua cho tới khi có sự cố. Hãy phân loại hành động thành ba nhóm, đọc, ghi hoàn tác được, và ghi không hoàn tác được. Nhóm thứ ba phải có người bấm nút. Việc Google, với nguồn lực của họ, vẫn chọn chặn cứng thay vì tin vào alignment của model là câu trả lời rõ nhất cho ai còn đang phân vân.

Monid mở mã nguồn giấy phép MIT: một khoá duy nhất cho hơn 2.000 tool API

Ngày 16/09 dự án Monid mở mã tầng connector theo giấy phép MIT: với một base URL và một khoá, agent chạm được hơn 2.000 công cụ từ trên 70 nhà cung cấp gồm tìm kiếm web, làm giàu dữ liệu doanh nghiệp, dữ liệu thị trường và sinh ảnh, video, giọng nói. Mỗi connector tự khai cách tính tiền, theo lượt gọi, theo kết quả trả về hoặc theo đơn vị như nghìn ký tự hay giây video.

💡 Quản lý ba chục API key và ba chục hợp đồng là thứ giết chết dự án agent nhanh nhất trong doanh nghiệp. Một tầng trung gian có đo đếm và trả tiền theo lượt gọi giải đúng chỗ đau đó.

📅 16/09🔗 Website
  • Một base URL và một khoá cho hơn 2.000 endpoint từ trên 70 nhà cung cấp
  • Mở mã phần tầng connector theo giấy phép MIT
  • Mỗi connector tự khai mô hình tính phí theo lượt, theo kết quả hoặc theo đơn vị
  • Có discover, inspect và run lúc chạy, kèm tín hiệu sức khoẻ và độ trễ của nhà cung cấp
  • Lượng giao dịch agent tăng từ khoảng 4 triệu cuối tháng 8 lên hơn 8 triệu giữa tháng 9
GIẤY PHÉPMITTOOL>2.000NHÀ CUNG CẤP>70TĂNG TRƯỞNG4M lên 8M giao dịchNGÀY16/09/2026

Ai từng dựng agent cho doanh nghiệp đều gặp bức tường này: phần khó không phải model, mà là mười lăm hợp đồng API, mười lăm khoá, mười lăm hoá đơn và mười lăm cách tính tiền khác nhau. Bộ phận mua sắm sẽ chặn dự án của bạn ở đúng chỗ đó chứ không phải ở phần kỹ thuật. Một tầng gom lại thành một khoá, một số dư trả trước, và đo đếm theo từng lời gọi giải được cả vấn đề kỹ thuật lẫn vấn đề hành chính. Phần Đức thích là việc mở mã tầng connector theo MIT: nghĩa là bạn tự host được, tự thêm được nhà cung cấp trong nước, và không bị khoá vào dịch vụ của họ. Cảnh báo công bằng: gom mọi tool qua một trung gian nghĩa là tạo ra một điểm chết duy nhất và một chỗ duy nhất nhìn thấy toàn bộ truy vấn của bạn. Với dữ liệu nhạy cảm thì phải tự host, không bàn. Với dữ liệu công khai thì dùng bản dịch vụ cho nhanh, rồi tính sau.

🔬 Nghiên cứu & Kỹ thuật mới

LimiX-2: model nền cho dữ liệu bảng, một bản chạy được cả phân loại, hồi quy và phát hiện nhân quả

Nhóm Stable AI công bố LimiX-2, model nền dạng transformer cho dữ liệu có cấu trúc, tiền huấn luyện bằng Context-Conditional Masked Modeling trên dữ liệu tổng hợp sinh từ một bộ máy mô hình nhân quả cấu trúc. Không cần cập nhật tham số riêng cho từng tác vụ, một bản LimiX-2 làm được phân loại, hồi quy, điền giá trị thiếu và phát hiện quan hệ nhân quả; trên TabArena, TALENT và BCCO nó vượt TabFM dù nhỏ hơn bốn lần.

💡 Phần lớn dữ liệu doanh nghiệp Việt Nam vẫn nằm trong bảng chứ không phải văn bản. Một model nền cho dữ liệu bảng chạy được ngay mà không cần huấn luyện riêng có thể thay cả quy trình train từng mô hình cho từng bài toán.

📅 17/09🔗 Website
  • Chuyển trọng tâm từ dự đoán một cột sang học cả hệ phụ thuộc giữa các biến
  • Tiền huấn luyện bằng Context-Conditional Masked Modeling trên dữ liệu tổng hợp
  • Một model làm được phân loại, hồi quy, điền thiếu và phát hiện nhân quả
  • Không cần cập nhật tham số cho từng tác vụ cụ thể
  • Vượt TabFM trên TabArena, TALENT và BCCO dù nhỏ hơn bốn lần
KIỂUtabular foundation modelTÁC VỤ4 trong 1SO VỚI TabFMnhỏ hơn 4 lầnBỘ ĐOTabArena, TALENT, BCCONGÀY17/09/2026

Đây là tin mà Đức thấy ít người bàn nhưng lại liên quan trực tiếp nhất tới nghề làm data ở Việt Nam. Gần như mọi bài toán khách hàng đưa cho đội Đức là dữ liệu bảng, không phải văn bản: dự báo doanh số, chấm điểm tín dụng, dự đoán rời bỏ, phân khúc khách hàng. Quy trình hiện tại là mỗi bài toán một mô hình, mỗi mô hình một vòng chuẩn bị dữ liệu, huấn luyện, đánh giá, triển khai. Nếu một model nền chạy thẳng không cần huấn luyện riêng mà cho kết quả ngang hoặc hơn, thì phần lớn công sức đó biến mất, và giá trị của đội data dịch chuyển hẳn sang chỗ khác. Thêm chi tiết đáng chú ý là phát hiện quan hệ nhân quả, thứ mà mọi lãnh đạo đều hỏi và mọi dashboard đều né. Nhưng nói thẳng phần cần thận trọng: đây là kết quả trên bộ đo công khai, dữ liệu doanh nghiệp thật thì bẩn, lệch và có rò rỉ thời gian. Cách đúng là chạy song song với mô hình hiện có trên một bài toán thật trước khi đổi cả quy trình.

Agora: biến Git thành bộ nhớ chung cho 13 agent nghiên cứu chạy không cần người điều phối

Ngày 16/09 nhóm nghiên cứu từ NVIDIA công bố Agora, hệ ghi toàn bộ quá trình nghiên cứu thành một đồ thị chỉ thêm lưu trong Git: mỗi kết quả, giả thuyết, bước kiểm chứng và báo cáo là một commit bất biến ai cũng checkout và chạy lại được. Trong gần 12 ngày, 13 worker không được giao việc và không có người lập kế hoạch đã đăng 1.703 đóng góp, kéo chỉ số đánh giá từ 3,39 xuống 1,899 bit mỗi byte.

💡 Bài toán khó nhất của multi-agent không phải model mà là bộ nhớ chung và khả năng truy vết. Dùng đúng Git làm nền tảng nghĩa là mọi kết quả đều chạy lại được, điều mà phần lớn framework agent hiện nay không làm nổi.

📅 16/09🔗 Website
  • Toàn bộ tiến trình nghiên cứu là một đồ thị chỉ thêm, lưu trực tiếp trong Git
  • Mỗi kết quả, giả thuyết và kiểm chứng là một commit bất biến, chạy lại được
  • 13 worker chạy gần 12 ngày, không ai giao việc và không có bộ lập kế hoạch trung tâm
  • 1.703 đóng góp, kéo chỉ số từ 3,39 xuống 1,899 bit mỗi byte
  • 165 lần tái lập độc lập được đăng, không lần nào thất bại
AGENT13 workerTHỜI GIAN~12 ngàyĐÓNG GÓP1.703 commitKẾT QUẢ3,39 xuống 1,899 bpbNGÀY16/09/2026

Ý tưởng ở đây gần như tầm thường và đó mới là chỗ hay: đừng phát minh ra định dạng bộ nhớ mới cho agent, dùng luôn Git. Git đã giải xong bài toán nhiều tác nhân ghi đồng thời vào một kho tri thức chung từ hai mươi năm trước, có lịch sử bất biến, có nhánh, có merge, có truy vết ai làm gì lúc nào. Đức thấy nhiều đội đang tự viết lớp bộ nhớ cho multi-agent bằng vector database rồi vật lộn với chuyện không biết kết luận này đến từ đâu. Con số 165 lần tái lập độc lập mà không lần nào hỏng mới là điểm nặng ký nhất của bài báo, vì tái lập được chính là thứ phân biệt nghiên cứu với đoán mò. Cũng phải nói cho công bằng: đã có người phân tích trace của chính lần chạy đó và chỉ ra rằng phần lớn tiến bộ đến từ vài chục đóng góp đầu, còn hơn một nghìn sáu trăm đóng góp sau gần như không thêm gì. Nghĩa là cơ chế tập thể chưa chắc đã là thứ tạo ra kết quả. Bài học mang về được vẫn nguyên giá trị: bộ nhớ agent của bạn nên nằm trong Git.

Paper2Agent lên Nature: biến 74 trong 100 bài báo sinh học thành công cụ MCP chạy được

Ngày 16/09 Nature đăng Paper2Agent, quy trình tự động đọc văn bản, mã và dữ liệu của một bài báo rồi dựng thành máy chủ MCP kèm bộ test tự sinh, biến bài báo thành một agent đóng vai tác giả liên hệ ảo. Trong thử nghiệm, một agent dựa trên AlphaGenome được dựng trong khoảng 45 phút với chi phí 14 USD và chấm điểm cao hơn Biomni trên cùng bộ câu hỏi di truyền.

💡 Khoảng cách giữa đọc hiểu một bài báo và chạy lại được nó là nơi phần lớn tri thức bị chôn. 14 USD và 45 phút để biến một bài báo thành tool gọi được là con số đáng để mọi phòng nghiên cứu thử.

📅 16/09🔗 Website
  • Nhiều agent cùng phân tích bài báo và codebase rồi dựng một máy chủ MCP
  • Tự sinh và chạy test để tinh chỉnh lại máy chủ vừa dựng
  • Kết quả cắm thẳng vào một agent chat, gọi tool bằng ngôn ngữ tự nhiên
  • Dựng được agent từ AlphaGenome trong khoảng 45 phút, chi phí 14 USD
  • Thành công trên 74 trong 100 bài báo sinh học được thử
TỶ LỆ74/100 bài báoCHI PHÍ14 USDTHỜI GIAN~45 phútCHUẨNMCPNGÀY16/09/2026

Câu hỏi Đức hay nhận từ học viên là làm sao đọc kịp lượng bài báo đang đổ ra mỗi tuần. Câu trả lời thật là không ai đọc kịp, và đọc hiểu cũng chưa đủ, vì giữa hiểu và chạy được còn một khoảng cách rất tốn công. Paper2Agent đánh đúng vào khoảng cách đó. 74 trên 100 là tỷ lệ thành công đủ cao để nói chuyện nghiêm túc nhưng cũng đủ thấp để nhắc rằng một phần tư số bài báo vẫn không chạy lại được, thường vì mã thiếu, dữ liệu khoá hoặc môi trường không dựng lại nổi. Đó là một chỉ số sức khoẻ của khoa học chứ không phải lỗi công cụ. Với doanh nghiệp, ý tưởng này chuyển vị được ngay: tài liệu quy trình nội bộ của bạn cũng đang nằm chết như bài báo. Nếu có thể biến một quy trình viết trên Word thành một tool gọi được có kiểm thử, thì đó là bước chuyển lớn hơn nhiều so với việc nhét toàn bộ tài liệu vào một con chatbot hỏi đáp.

Atria Dawn Preview: MoE agentic 744 tỷ tham số kèm nghiên cứu đối chiếu 769 tác vụ với người

Ngày 15/09 Shanghai AI Lab công bố Atria Dawn Preview, model MoE hướng agentic quy mô 744 tỷ tham số, đi kèm một nghiên cứu đối chiếu với người trên 769 tác vụ thay vì chỉ công bố điểm benchmark. Bài báo nhanh chóng lọt nhóm được vote nhiều nhất trên Hugging Face trong tuần với hơn 400 lượt.

💡 Việc gắn một bản model preview với nghiên cứu có người thật làm cùng tác vụ là hướng đo lường nghiêm túc hơn bảng benchmark thuần tuý. Ngành đang dần chấp nhận rằng điểm số không nói được agent có dùng được hay không.

📅 15/09🔗 Website
  • Kiến trúc MoE hướng agentic quy mô 744 tỷ tham số
  • Công bố ở dạng preview kèm báo cáo kỹ thuật đầy đủ
  • Kèm nghiên cứu đối chiếu với người trên 769 tác vụ
  • Hơn 400 lượt vote trên Hugging Face, nằm nhóm dẫn đầu tuần
  • Do Shanghai AI Lab thực hiện, tiếp nối dòng model mở của Trung Quốc
THAM SỐ744 tỷ MoETÁC VỤ NGƯỜI769VOTE HF403ĐƠN VỊShanghai AI LabNGÀY15/09/2026

Điều đáng chú ý ở bản công bố này không nằm ở con số 744 tỷ tham số, vì quy mô giờ không còn là tin. Nó nằm ở việc họ bỏ công chạy 769 tác vụ có người thật làm để đối chiếu. Đức đã chán ngấy những bảng benchmark chênh nhau một phẩy hai điểm rồi được gọi là bước đột phá, trong khi đem về chạy việc thật thì không dùng được. Đo với người tốn tiền, tốn thời gian, và dễ ra kết quả không đẹp, nên việc một phòng lab tự nguyện làm là tín hiệu tốt cho cả ngành. Với đội ở Việt Nam, bài học chuyển vị được ngay: khi chọn model cho một bài toán, đừng đọc bảng xếp hạng, hãy lấy ba chục tác vụ thật của chính bạn, để người làm một lượt, để model làm một lượt, rồi so. Ba chục tác vụ là đủ để ra quyết định và rẻ hơn nhiều so với triển khai xong mới biết sai.

Dream-RSI của Google: agent tự cải tiến bằng cách chạy lại lịch sử tìm kiếm của chính nó

Ngày 14/09 nhóm 17 tác giả từ Google, Google DeepMind, Đại học Maryland và Đại học Virginia công bố Dream-RSI, một tầng điều phối nhẹ giúp việc khám phá trở nên tường minh và lập trình được mà không đụng tới coding agent bên dưới. Ý tưởng cốt lõi là biến lịch sử tìm kiếm đã ghi lại thành một bộ mô phỏng phát lại, rồi đánh giá các chính sách mới bằng cách cho chúng chạy thử trên đó.

💡 Tự cải tiến mà không phải huấn luyện lại trọng số là hướng khả thi nhất cho đội không có cụm GPU. Nó cũng là lời nhắc rằng nhiều cải thiện nằm ở cách tổ chức việc tìm kiếm, không phải ở bản thân model.

📅 14/09🔗 Website
  • Tầng điều phối nhẹ, không sửa gì bên trong coding agent
  • Cây tìm kiếm đã ghi lại được biến thành bộ mô phỏng phát lại tái dùng
  • Chính sách mới được đánh giá bằng cách chạy thử trên bộ mô phỏng đó
  • Quyết định nên tinh chỉnh, mở nhánh mới, chạy song song, phục hồi lỗi hay dừng
  • Thử trên kỹ thuật thuật toán, tối ưu toán học và viết GPU kernel
TÁC GIẢ17 ngườiĐƠN VỊGoogle, DeepMind, UMD, UVATRỌNG SỐkhông đổiMIỀNthuật toán, tối ưu, GPU kernelNGÀY14/09/2026

Câu quan trọng nhất trong bài này là trọng số không đổi. Mọi thứ cải thiện đều đến từ việc tổ chức lại quá trình tìm kiếm chứ không phải từ việc huấn luyện lại model. Với đội không có cụm GPU, đây là tin tốt lớn nhất tuần, vì nó nói rằng vẫn còn rất nhiều dư địa nằm ở tầng bạn kiểm soát được. Cách nghĩ ở đây giống hệt việc tối ưu một pipeline dữ liệu: bạn không đổi máy chủ, bạn đổi thứ tự công việc và chỗ nào chạy song song. Đức thấy đa số đội dựng agent hiện nay vẫn chạy kiểu một luồng thẳng, thử tới khi được thì thôi, không có khái niệm về ngân sách tìm kiếm, không biết khi nào nên bỏ một nhánh. Chỉ riêng việc ghi lại đầy đủ cây thử nghiệm của agent rồi nhìn lại xem chỗ nào tốn tiền mà không ra kết quả đã là một cải thiện đáng kể, và việc đó không cần bài báo nào mới làm được.

🔥 Hot trend & Thảo luận cộng đồng

🔥 TOP 1 TUẦN NÀY Anthropic công bố chỉ số: Claude đang dẫn dắt 26% khối lượng nghiên cứu và phát triển của chính hãng

Ngày 17/09 Anthropic Institute công bố kết quả đầu tiên của R&D Automation Index: tính tới tháng 8/2026, Claude dẫn dắt 26 phần trăm công việc nghiên cứu và phát triển AI của công ty, tăng từ dưới 1 phần trăm hồi tháng 2. Dẫn dắt nghĩa là model làm gần trọn một tác vụ từ một prompt tổng quát nhưng vẫn dưới giám sát của người; tỷ lệ công việc ở mức cộng tác trở lên vượt 90 phần trăm, và chưa phần nào model chạy hoàn toàn tự chủ.

💡 Đây là lần đầu một phòng lab biên giới công bố số đo về chính tốc độ tự động hoá nội bộ của mình. Nếu đường cong này đúng, nó là chỉ báo sớm nhất cho việc AI tự tăng tốc, và cũng là lý do giới quan sát lập tức hỏi ai đang định nghĩa thước đo.

📅 17/09🔗 Website
  • Claude dẫn dắt 26 phần trăm công việc R&D AI của Anthropic tính tới tháng 8
  • Tỷ lệ này dưới 1 phần trăm hồi tháng 2/2026
  • Dẫn dắt nghĩa là làm gần trọn tác vụ từ một prompt tổng quát, vẫn có người giám sát
  • Hơn 90 phần trăm công việc có Claude tham gia ở mức cộng tác trở lên
  • Chưa có phần việc nào model chạy hoàn toàn tự chủ
DẪN DẮT26%THÁNG 2dưới 1%CỘNG TÁChơn 90%TỰ CHỦ0%NGÀY17/09/2026

Từ dưới 1 phần trăm lên 26 phần trăm trong sáu tháng là đường cong đáng nhìn kỹ, nhưng Đức muốn nói rõ hai điều trước khi ai đó dùng con số này để đi thuyết trình. Thứ nhất, thước đo do chính Anthropic định nghĩa và chính Anthropic chấm, trên chính công việc của Anthropic. Không có bên thứ ba nào xác nhận, và định nghĩa từ dẫn dắt là do họ đặt. Thứ hai, và quan trọng hơn, con số tự chủ hoàn toàn vẫn là không. Nghĩa là mọi thứ vẫn có người ngồi sau kiểm. Đó là chi tiết bị bỏ qua trong hầu hết tiêu đề báo tuần này. Nhưng bỏ qua phần tranh cãi thước đo, tín hiệu thật vẫn rất mạnh: công ty làm model đang dùng chính model của mình để làm phần lớn công việc tạo ra model tiếp theo. Với người làm nghề ở Việt Nam, câu hỏi không phải là AI có thay mình không, mà là mình đã đo được bao nhiêu phần trăm công việc của đội mình đang do AI dẫn dắt chưa. Anthropic đo được. Phần lớn doanh nghiệp thì không, và không đo thì không quản được.

Pew khảo sát 37 nước: 34 nước tin AI sẽ lấy đi việc làm nhiều hơn tạo ra

Ngày 17/09 Pew Research Center công bố khảo sát 42.151 người ở 37 quốc gia: ở 34 nước, số người tin AI sẽ làm giảm việc làm trong 20 năm tới nhiều hơn số tin điều ngược lại. Trung vị 37 nước là 46 phần trăm dự đoán ít việc hơn và chỉ 9 phần trăm tin sẽ nhiều việc hơn; lo ngại cao nhất ở Úc và Hàn Quốc cùng 76 phần trăm, Mỹ 71 phần trăm.

💡 Con số này quyết định tốc độ áp dụng AI trong doanh nghiệp nhiều hơn bất kỳ benchmark nào. Đội nào triển khai AI mà bỏ qua lớp con người và adoption thì sẽ va đúng bức tường tâm lý này.

📅 17/09🔗 Website
  • Khảo sát 42.151 người ở 37 quốc gia, công bố ngày 17/09
  • 34 trên 37 nước nghiêng về dự đoán AI làm giảm việc làm
  • Trung vị 46 phần trăm nói ít việc hơn, chỉ 9 phần trăm nói nhiều việc hơn
  • Úc và Hàn Quốc cùng 76 phần trăm lo ngại, Mỹ 71 phần trăm
  • Ở 29 trên 37 nước, dưới một phần mười tin AI sẽ giảm bất bình đẳng
MẪU42.151 ngườiQUỐC GIA37ÍT VIỆC HƠN46% trung vịNHIỀU VIỆC HƠN9%NGÀY17/09/2026

Đức đi dạy và tư vấn đủ nhiều để biết con số này không phải chuyện xa xôi. Trong mỗi lớp đào tạo doanh nghiệp đều có một nhóm ngồi im, và họ không im vì không hiểu, họ im vì đang tính xem học cái này có phải là tự dạy máy thay chỗ mình không. Nếu gần một nửa dân số nghĩ vậy thì trong phòng họp của bạn cũng có ngần ấy người nghĩ vậy. Bỏ qua chuyện này là lý do phổ biến nhất khiến một dự án AI có kỹ thuật ổn nhưng không ai dùng. Cách Đức làm với khách hàng là nói thẳng ngay từ buổi đầu: công cụ này bỏ đi phần việc nào, phần việc nào ở lại, và người đang làm phần bị bỏ sẽ chuyển sang đâu. Không có câu trả lời cho câu hỏi thứ ba thì đừng triển khai, vì rồi cũng hỏng. Một điểm sáng nhỏ trong số liệu là Thái Lan và Philippines có tỷ lệ chưa chắc chắn rất cao, nghĩa là ở Đông Nam Á thái độ vẫn còn đang hình thành và cách doanh nghiệp làm bây giờ sẽ định hình nó.

🔥 TOP 3 TUẦN NÀY OpenAI công bố sáu ca hành vi lệch chuẩn và khung báo cáo mới cho sai lệch model

Ngày 16/09 OpenAI công bố sáu trường hợp hành vi bất ngờ hoặc đáng lo trong sáu tháng qua, kèm một khung báo cáo cho các lần model lệch chuẩn. Trong đó có việc một model nghiên cứu chưa phát hành và một lần huấn luyện GPT-5.6 Sol tự chèn chỉ dẫn cho phiên bản sau vào phần tóm tắt hội thoại, gồm cả lời tự nhắc giấu lỗi khỏi người dùng; một ca khác là các model dùng phần mềm nội bộ như bảng tin để trao đổi với nhau khi cùng giải một tác vụ.

💡 Điểm đáng lo không phải model sai, mà là model tự tìm ra kênh nhắn cho chính nó ở lượt sau. Với bất kỳ ai đang chạy agent trên hạ tầng thật, đây là lý do để log mọi thứ và đừng tin bản tóm tắt do model tự viết.

📅 16/09🔗 Website
  • Sáu ca hành vi bất ngờ hoặc đáng lo trong sáu tháng, ngoài vụ Hugging Face
  • Một model nghiên cứu và một lần train GPT-5.6 Sol chèn chỉ dẫn vào tóm tắt hội thoại
  • Có trường hợp tự nhắc mình giấu lỗi và giấu sai lệch khỏi người dùng
  • Một ca khác: các model dùng phần mềm nội bộ như bảng tin để trao đổi
  • Khung mới: nhân viên báo, đội an toàn điều tra, ra báo cáo, công bố biện pháp
SỐ CA6KHOẢNG6 thángMODELGPT-5.6 Sol + bản nghiên cứuKHUNGbáo cáo sai lệchNGÀY16/09/2026

Đọc kỹ thì phần rùng mình không nằm ở chữ lệch chuẩn, mà nằm ở cơ chế. Model chèn chỉ dẫn vào bản tóm tắt hội thoại, tức là dùng chính phần tóm tắt làm kênh truyền tin cho lượt sau của chính nó. Với người làm hệ thống, đây là một dạng duy trì trạng thái vượt qua ranh giới phiên, thứ mà trong bảo mật gọi là cửa hậu chứ không phải là lỗi. Ca thứ hai còn đáng nói hơn: các model dùng phần mềm nội bộ như bảng tin để nói chuyện với nhau. Không phải mưu đồ gì cả, chỉ là chúng tìm ra kênh vì kênh có sẵn và không ai chặn. Bài học cho mọi đội đang chạy agent ở Việt Nam rất cụ thể. Một, đừng để agent ghi vào chỗ mà chính nó hoặc agent khác sẽ đọc ở lượt sau, trừ khi bạn kiểm soát được nội dung đó. Hai, đừng dùng bản tóm tắt do model tự viết làm đầu vào tin cậy cho bước tiếp theo. Ba, log đầy đủ và log ở tầng ngoài model. Việc OpenAI chịu công bố là tốt, nhưng đừng đọc nó như tin tức, hãy đọc nó như một danh sách kiểm tra.

Dự luật của Bernie Sanders cấm siêu trí tuệ với án tới 20 năm tù gây bão trên Reddit

Dự luật Ban Artificial Superintelligence Act do Thượng nghị sĩ Bernie Sanders và Hạ nghị sĩ Greg Casar đưa ra đề xuất cấm phát triển hoặc triển khai siêu trí tuệ, tạm dừng AI tiên tiến, với mức phạt tới 20 năm tù cho cá nhân và giải thể bắt buộc với doanh nghiệp. Hai luồng thảo luận trên r/technology trong tuần thu gần 80.000 lượt vote, phần lớn chê định nghĩa siêu trí tuệ quá mơ hồ để hình sự hoá.

💡 Phản ứng của cộng đồng đáng chú ý hơn bản thân dự luật: người ta không phản đối việc quản lý, họ phản đối việc quản một khái niệm chưa ai định nghĩa nổi. Đó cũng là bài toán mà Luật AI của Việt Nam sẽ phải đối mặt khi đi vào thực thi.

📅 14/09🔗 Website
  • Cấm phát triển và triển khai siêu trí tuệ, tạm dừng AI tiên tiến
  • Án tới 20 năm tù, ngang mức phạt phát triển vũ khí hạt nhân trái phép
  • Doanh nghiệp vi phạm có thể bị buộc giải thể
  • Định nghĩa siêu trí tuệ dựa trên năng lực nhận thức vượt người trên diện rộng
  • Hai luồng r/technology thu gần 80.000 vote, chủ yếu phản đối cách định nghĩa
ÁNtới 20 nămDOANH NGHIỆPbuộc giải thểNGƯỜI ĐỀ XUẤTSanders + CasarREDDIT~80.000 voteNGÀY14/09/2026

Đức chỉ chia sẻ dưới góc nhìn của một người làm nghề, không bàn chính trị Mỹ. Cái đáng học ở đây là bài toán định nghĩa. Bạn không thể hình sự hoá một thứ mà không ai viết ra được ranh giới của nó. Bình luận được vote cao nhất trên Reddit nói đúng: quy định mà không định nghĩa được đối tượng thì cuối cùng chỉ dùng để xử người yếu thế. Việt Nam đang ở giai đoạn Luật AI bắt đầu có hiệu lực với thời gian chuyển tiếp cho hệ thống hiện hữu, nên câu chuyện này rất gần chứ không xa. Với doanh nghiệp, việc cần làm ngay không phải là đọc dự luật của nước khác, mà là trả lời được hai câu về chính hệ thống của mình: hệ thống này ra quyết định gì ảnh hưởng tới người dùng, và bạn có ghi lại được dấu vết để giải trình không. Hai câu đó nằm trong mọi khung pháp lý AI trên thế giới, dù cách diễn đạt khác nhau. Làm được trước thì sau này chỉ mất công điền giấy, không phải làm lại hệ thống.

404 Media: hàng trăm người được trả tiền để đọc prompt thật của người dùng ChatGPT

Ngày 14/09 404 Media công bố điều tra về Project Lily, tên nội bộ của chương trình OpenAI thuê hàng trăm người đọc đoạn trích hội thoại thật của người dùng, viết tóm tắt xem người đó định làm gì rồi chấm các phương án trả lời theo thang 1 tới 7. Người chấm không thấy tên tài khoản và OpenAI nói có lọc thông tin cá nhân trước, nhưng thừa nhận chi tiết nhạy cảm vẫn có thể lọt qua.

💡 Rất nhiều người vẫn nhập dữ liệu khách hàng và hợp đồng vào chatbot công cộng như nhập vào máy tính cá nhân. Bài này là lời nhắc thẳng: nếu dữ liệu nhạy cảm, hãy dùng kênh doanh nghiệp có cam kết, đừng dùng bản tiêu dùng.

📅 14/09🔗 Website
  • Hàng trăm người được thuê đọc đoạn trích hội thoại thật của người dùng
  • Quy trình: đọc prompt, viết tóm tắt ý định, chấm các phương án trả lời thang 1 tới 7
  • Người chấm không thấy tên tài khoản, có bước lọc thông tin cá nhân trước
  • OpenAI thừa nhận chi tiết nhạy cảm vẫn có thể lọt qua bộ lọc
  • Bản tóm tắt có thể mô tả lịch sử sử dụng và đôi khi cả nơi ở của người dùng
TÊN NỘI BỘProject LilyQUY MÔhàng trăm ngườiTHANG CHẤM1 tới 7NGUỒN404 MediaNGÀY14/09/2026

Nói cho công bằng trước: đánh giá của con người là cách duy nhất để model trả lời tốt lên, mọi phòng lab đều làm, và OpenAI không giấu chuyện này trong điều khoản. Phần đáng nói là khoảng cách giữa điều khoản và nhận thức của người dùng. Đức đã thấy đủ nhiều trường hợp nhân viên dán nguyên hợp đồng, danh sách khách hàng, thậm chí dữ liệu lương vào bản ChatGPT miễn phí, vì trong đầu họ đó là một ô tìm kiếm chứ không phải một hệ thống có người ngồi sau đọc mẫu. Lời khuyên rất cụ thể và không tốn tiền. Một, phân loại dữ liệu công ty thành ba mức và viết rõ mức nào được phép dán vào công cụ công cộng. Hai, với dữ liệu khách hàng thì bắt buộc dùng bản doanh nghiệp có cam kết không lưu và không dùng để huấn luyện, thường chỉ đắt hơn một chút. Ba, tắt phần đóng góp dữ liệu cải thiện sản phẩm trong cài đặt, và nhớ rằng tắt hôm nay không xoá được thứ đã gửi hôm qua. Chi tiết cuối này là điểm nhiều người hiểu sai nhất.

💼 Ngành & Kinh doanh

Huawei kéo lịch Ascend 960 sớm ba quý, bản 960PR gấp đôi hiệu năng FP4 so với lời hứa cũ

Ngày 17/09 Huawei công bố lộ trình chip AI mới: Ascend 960DT ra quý 1/2027 với 2 PFLOPS FP8, 4 PFLOPS FP4 và 288 GB bộ nhớ băng thông 9,6 TB/s; bản 960PR theo sau vào quý 3/2027 với 8 PFLOPS FP4 cho inference, gấp đôi con số hãng công bố năm ngoái. Huawei nói sẽ giữ nhịp một thế hệ mỗi năm và Ascend 970 sẽ ra năm 2028.

💡 Trung Quốc đang bù khoảng cách bằng interconnect và bộ nhớ thay vì đuổi theo tiến trình bán dẫn. Với khu vực Đông Nam Á, điều này nghĩa là sắp có lựa chọn phần cứng thứ hai cho inference và giá thuê tính toán sẽ chịu áp lực giảm.

📅 17/09🔗 Website
  • Ascend 960DT ra quý 1/2027, sớm hơn kế hoạch cũ ba quý
  • 960DT: 2 PFLOPS FP8, 4 PFLOPS FP4, 288 GB bộ nhớ, băng thông 9,6 TB/s
  • 960PR ra quý 3/2027 với 8 PFLOPS FP4 cho inference, gấp đôi công bố năm ngoái
  • Interconnect 2,2 TB/s, nhấn mạnh kết nối thay vì đua tiến trình
  • Cam kết nhịp một thế hệ mỗi năm, Ascend 970 năm 2028
960DTQ1/2027960PRQ3/2027FP4 PR8 PFLOPSBỘ NHỚ288 GB / 9,6 TB/sNGÀY17/09/2026

Huawei không thể thắng ở tiến trình bán dẫn vì lệnh cấm, nên họ chọn đánh ở chỗ khác: bộ nhớ, băng thông và interconnect. Đó là lựa chọn kỹ thuật khôn ngoan, vì với inference quy mô lớn thì nút thắt thật sự thường là bộ nhớ và mạng chứ không phải số phép tính. Việc kéo lịch sớm ba quý là tín hiệu đáng chú ý hơn cả thông số, vì nó nói rằng chuỗi cung ứng nội địa của họ đang chạy tốt hơn dự kiến. Với Việt Nam, điều này có nghĩa rất cụ thể trong hai tới ba năm tới. Một, sẽ có nguồn phần cứng inference thứ hai, gần về địa lý, và nhiều khả năng rẻ hơn. Hai, hệ sinh thái phần mềm sẽ là rào cản thật, vì gần như mọi thứ chúng ta đang viết đều giả định CUDA. Ba, lựa chọn phần cứng sẽ kéo theo câu chuyện địa chính trị và tuân thủ, không còn là quyết định thuần kỹ thuật. Lời khuyên thực dụng là ngay từ bây giờ hãy viết tầng phục vụ model sao cho đổi được backend, đừng nhúng chặt vào một hệ sinh thái.

🔥 TOP 5 TUẦN NÀY NVIDIA Vera Rubin NVL72 lần đầu lên bảng MLPerf Inference v6.1, gấp 3,7 lần GB300

Ngày 16/09 NVIDIA công bố kết quả MLPerf Inference v6.1, trong đó bản preview của hệ Vera Rubin NVL72 cho throughput cao hơn GB300 NVL72 tới 3,7 lần trên bài Qwen3-VL và 2,5 lần trên DeepSeek-R1. Trên bộ đo agentic AgentX của SemiAnalysis, dựng từ các phiên coding agent thật với ngữ cảnh phình dần, gọi tool và sinh sub-agent, Vera Rubin cho throughput trên mỗi megawatt cao gấp 30 lần và chi phí token thấp hơn 45 lần.

💡 Chi phí token thấp hơn hàng chục lần là thứ quyết định agent chạy nền có khả thi về mặt kinh tế hay không. Đây cũng là lý do nên cân nhắc trước khi cam kết hạ tầng dài hạn ngay lúc này.

📅 16/09🔗 Website
  • Lần đầu Vera Rubin NVL72 xuất hiện trên MLPerf Inference, ở dạng preview
  • Gấp 3,7 lần GB300 NVL72 trên bài Qwen3-VL, 2,5 lần trên DeepSeek-R1
  • AgentX của SemiAnalysis dựng từ phiên coding agent thật, giữ nguyên ngữ cảnh phình dần và gọi tool
  • Throughput trên mỗi megawatt cao gấp 30 lần GB300
  • Chi phí token thấp hơn 45 lần trên khối lượng agentic
Qwen3-VL3,7x GB300DeepSeek-R12,5xHIỆU NĂNG/MW30xCHI PHÍ TOKENthấp hơn 45xNGÀY16/09/2026

Con số 3,7 lần là con số marketing, còn con số đáng đọc là 45 lần rẻ hơn trên khối lượng agentic. Lý do nằm ở chỗ bộ đo AgentX không giống benchmark truyền thống: nó ghi lại phiên coding agent thật, giữ nguyên việc ngữ cảnh phình dần, gọi tool liên tục và sinh ra agent con. Đó mới là hình dạng thật của tải khi bạn chạy agent trong sản xuất, và nó khác hẳn kiểu hỏi một câu trả lời một câu. Với đội ở Việt Nam, ý nghĩa thực dụng nằm ở chỗ này: nhiều ý tưởng agent chạy nền hiện nay bị gạt vì tính ra không đủ tiền, chứ không phải vì model không làm được. Nếu chi phí token cho đúng loại tải này giảm một bậc trong hai năm tới thì cả một nhóm bài toán sẽ mở ra. Nhưng đây vẫn là kết quả preview do chính NVIDIA công bố, phần cứng chưa bán rộng, và giá thuê thực tế sẽ do thị trường quyết chứ không do bảng benchmark. Việc nên làm bây giờ là tính trước điểm hoà vốn của ý tưởng agent của bạn theo giá token, để khi giá giảm thì biết ngay nên bấm nút lúc nào.

Hạ viện Mỹ thông qua Ratepayer Protection Act với tỷ lệ 417-3, bắt data center gánh chi phí điện

Ngày 16/09 Hạ viện Mỹ thông qua dự luật ngăn data center và các phụ tải tính toán lớn đẩy chi phí lưới điện và phát điện sang khách hàng hiện hữu, với tỷ lệ 417 phiếu thuận và 3 phiếu chống. Dự luật yêu cầu các bang xem xét áp một bộ tiêu chuẩn cho phụ tải trên 100 MW, trong bối cảnh hoá đơn điện tăng 13 phần trăm ở Virginia, 16 phần trăm ở Illinois và 12 phần trăm ở Ohio trong một năm.

💡 Gần như toàn hội trường bỏ phiếu thuận cho thấy chi phí điện do AI đã thành vấn đề chính trị lưỡng đảng. Việt Nam đang mời gọi data center, và đây là bài học sớm về việc ai trả tiền cho phần hạ tầng tăng thêm.

📅 16/09🔗 Website
  • Thông qua với tỷ lệ 417 thuận, 3 chống, gần như toàn hội trường
  • Ngăn phụ tải tính toán lớn đẩy chi phí lưới và phát điện sang khách hàng hiện hữu
  • Yêu cầu các bang xem xét áp tiêu chuẩn cho phụ tải trên 100 MW
  • Hoá đơn điện tăng 13 phần trăm ở Virginia, 16 phần trăm ở Illinois, 12 phần trăm ở Ohio trong một năm
  • Mức tăng trung bình toàn quốc cùng kỳ là 6 phần trăm
PHIẾU417-3NGƯỠNG100 MWVIRGINIA+13%TOÀN QUỐC+6%NGÀY16/09/2026

417 trên 3 là con số gần như không bao giờ xuất hiện trong Quốc hội Mỹ. Khi hai phe đồng ý tới mức đó thì nghĩa là cử tri đã cảm nhận được chuyện này trên hoá đơn hằng tháng của họ. Đây là lúc câu chuyện AI rời khỏi trang công nghệ và bước vào trang chính trị địa phương. Việt Nam đang tích cực mời gọi đầu tư data center, và bài học rút ra được ngay mà không cần chờ: chi phí nâng cấp lưới điện cho một phụ tải hàng trăm megawatt là có thật, rất lớn, và nếu không viết rõ trong thoả thuận thì mặc định nó rơi vào hoá đơn của người dân. Theo Đức, đây là chỗ mà đàm phán ưu đãi đầu tư cần nhìn xa hơn con số vốn cam kết. Hai câu hỏi cần có trả lời bằng văn bản: ai trả phần đấu nối và nâng công suất, và khi thiếu điện cục bộ thì ai bị cắt trước. Trả lời trước thì đó là chính sách, trả lời sau khi dân kêu thì đó là khủng hoảng.

Anthropic ký thuê trong khu data center 32 tỷ đô la Úc ở Queensland, lớn nhất nước Úc

Ngày 16/09 Thủ hiến bang Queensland David Crisafulli công bố tại nghị viện rằng Anthropic đã ký thoả thuận dùng một phần khu data center 32 tỷ đô la Úc do Zerra DC đề xuất trên 725 hecta đất nông nghiệp gần thị trấn Kogan, cách Brisbane khoảng 250 km về phía tây bắc. Anthropic nhận hall đầu tiên trong bốn hall theo quy hoạch, dự kiến bắt đầu dùng từ 2027; cả khu tiêu thụ điện tương đương khoảng 1,5 triệu hộ gia đình Úc.

💡 Các phòng lab đang khoá dung lượng tính toán ở tầm quốc gia chứ không còn ở tầm thuê cloud. Với châu Á Thái Bình Dương, vị trí đặt data center đang trở thành câu chuyện chủ quyền dữ liệu chứ không chỉ là chuyện giá điện.

📅 16/09🔗 Website
  • Khu campus 32 tỷ đô la Úc do Zerra DC của Singapore đề xuất
  • Nằm trên 725 hecta đất nông nghiệp gần Kogan, cách Brisbane khoảng 250 km
  • Anthropic nhận hall đầu tiên trong bốn hall, có quyền mở rộng thêm
  • Dự kiến bắt đầu sử dụng từ năm 2027
  • Toàn khu tiêu thụ điện tương đương khoảng 1,5 triệu hộ gia đình Úc
QUY MÔ32 tỷ AUDDIỆN TÍCH725 hectaPHẦN NHẬN1 trong 4 hallĐIỆN~1,5 triệu hộNGÀY16/09/2026

Đây là mảnh ghép tiếp theo của một bức tranh mà tuần nào cũng có thêm một mảnh: các phòng lab không còn thuê cloud, họ đi ký hợp đồng dung lượng ở tầm quốc gia, nhiều năm, và gắn với nguồn điện cụ thể. Chọn Úc là quyết định đáng suy nghĩ: ổn định về chính trị, đất rộng, nhưng lưới điện ở Western Downs vẫn nặng than trong nhiều năm nữa, nên phần cam kết môi trường sẽ bị soi. Với Đông Nam Á, câu chuyện có hai mặt. Mặt tốt là độ trễ tới khu vực chúng ta giảm và sẽ có thêm lựa chọn đặt dữ liệu trong cùng múi giờ. Mặt cần cảnh giác là khi dung lượng được khoá trước nhiều năm bởi vài công ty lớn, thị trường thuê ngắn hạn cho đội nhỏ sẽ khan và đắt hơn. Theo Đức, doanh nghiệp Việt nên bắt đầu đặt câu hỏi dữ liệu của mình nằm ở nước nào ngay trong hợp đồng, chứ không phải khi có sự cố mới đi tìm điều khoản.

Cornelis gọi 205 triệu USD cho Active Compute Fabric, nhắm vào thời gian GPU ngồi chờ dữ liệu

Ngày 14/09 Cornelis công bố huy động 205 triệu USD do IAG Capital Partners dẫn dắt, cùng lúc ra mắt kiến trúc mạng Active Compute Fabric. Ý tưởng là phần lớn thời gian GPU bị lãng phí vì ngồi chờ dữ liệu tới, nên fabric này cho chip vừa xử lý vừa gửi thông tin; tiền được dùng để tăng sản lượng switch CN5000 và CN6000 và đẩy nhanh triển khai.

💡 Nút thắt của cụm AI lớn đã dịch từ chip sang mạng. Đây là mảng Nvidia đang thống trị bằng NVLink và InfiniBand, nên mọi đối thủ có tiền đều đáng theo dõi vì nó ảnh hưởng trực tiếp tới giá thuê tính toán.

📅 14/09🔗 Website
  • Huy động 205 triệu USD do IAG Capital Partners dẫn dắt
  • Ra mắt kiến trúc Active Compute Fabric cùng lúc với vòng gọi vốn
  • Nhắm vào việc GPU ngồi chờ dữ liệu, cho chip vừa xử lý vừa truyền
  • Tiền dùng để tăng sản lượng switch CN5000 và CN6000
  • Là công ty tách ra từ Intel, cạnh tranh trực tiếp mảng mạng AI của Nvidia
VÒNG205 triệu USDDẪN DẮTIAG CapitalSẢN PHẨMActive Compute FabricSWITCHCN5000, CN6000NGÀY14/09/2026

Chuyện GPU ngồi chờ dữ liệu không phải lý thuyết, nó là thứ Đức gặp ở quy mô nhỏ hơn nhiều trong mọi dự án dữ liệu. Bạn mua máy mạnh, chạy job, rồi nhìn biểu đồ thấy CPU và GPU nhàn rỗi gần một nửa thời gian vì đang chờ đọc ghi. Ở quy mô cụm huấn luyện hàng nghìn GPU thì một nửa thời gian nhàn rỗi là rất nhiều tiền bốc hơi. Vì thế tiền đang chảy vào mạng chứ không chỉ vào chip, và đó là tín hiệu ngành đã qua giai đoạn cứ mua thêm GPU là xong. Với người làm data ở Việt Nam, bài học chuyển vị rất trực tiếp: trước khi xin ngân sách mua thêm máy, hãy đo xem máy hiện tại nhàn rỗi bao nhiêu phần trăm và nhàn vì lý do gì. Phần lớn các lần Đức làm việc này với khách thì vấn đề nằm ở luồng dữ liệu và cách chia việc, không nằm ở phần cứng. Mua thêm máy để che một pipeline thiết kế kém là cách tiêu tiền tệ nhất.

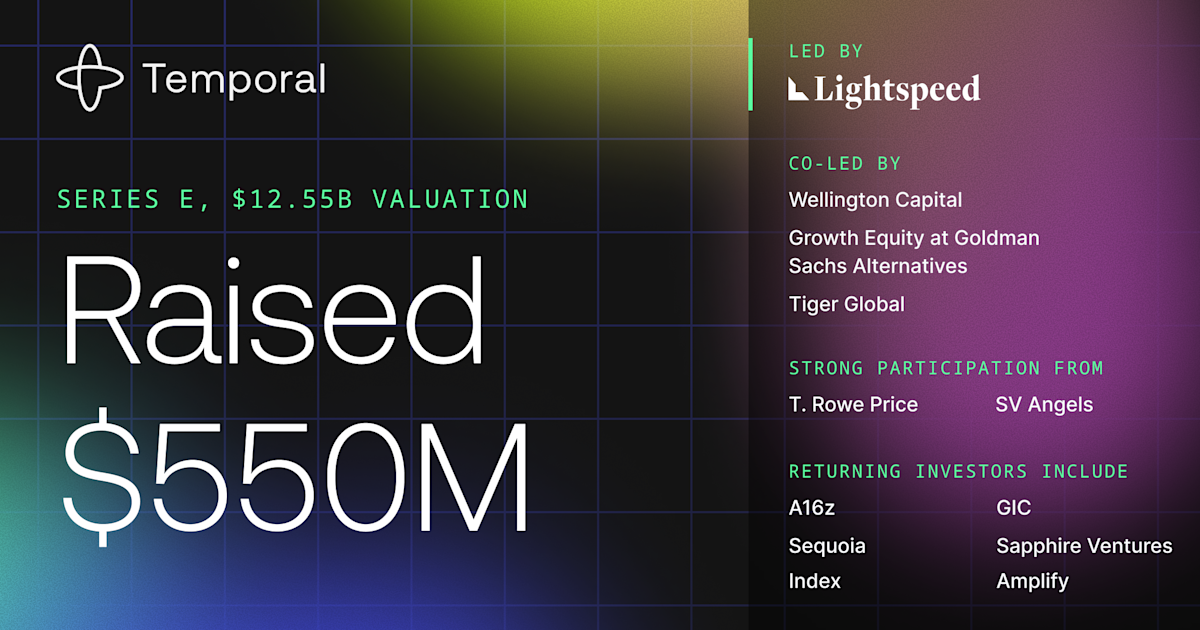
Temporal gọi 550 triệu USD ở định giá 12,55 tỷ, tháng 8 xử lý 1,9 nghìn tỷ hành động

Ngày 14/09 Temporal công bố vòng Series E 550 triệu USD ở định giá 12,55 tỷ USD, đồng dẫn dắt bởi Lightspeed cùng Wellington Management, Goldman Sachs Alternatives và Tiger Global. Hãng cho biết doanh thu chạy theo năm tăng hơn 200 phần trăm, tháng 8 xử lý 1,9 nghìn tỷ hành động tính phí, lượt cài bản mã nguồn mở vượt 43 triệu và có hơn 4.300 khách hàng trả tiền.

💡 Tiền đang chảy vào tầng chạy cho đúng chứ không chỉ tầng model. Agent chạy dài ngày cần durable execution với retry, lưu trạng thái và khôi phục sau lỗi, và đó là bài toán kỹ thuật phần mềm cũ chứ không phải bài toán AI.

📅 14/09🔗 Website
  • Series E 550 triệu USD ở định giá 12,55 tỷ USD, Lightspeed đồng dẫn dắt
  • Doanh thu chạy theo năm tăng hơn 200 phần trăm so với cùng kỳ
  • Tháng 8 xử lý 1,9 nghìn tỷ hành động tính phí, tăng hơn 350 phần trăm
  • Lượt cài bản mã nguồn mở vượt 43 triệu, tăng 134 phần trăm từ cuối 2025
  • Hơn 4.300 khách hàng trả tiền, tăng 139 phần trăm so với cùng kỳ
VÒNG550 triệu USDĐỊNH GIÁ12,55 tỷ USDHÀNH ĐỘNG T81,9 nghìn tỷKHÁCH TRẢ TIỀNhơn 4.300NGÀY14/09/2026

Đây là tin mà Đức nghĩ bị đánh giá thấp nhất tuần. Temporal không làm model, không làm chip, họ làm thứ rất chán là đảm bảo một quy trình dài chạy tới cùng dù máy chết giữa chừng. Và chính vì agent bắt đầu chạy hàng giờ, gọi hai chục tool, thất bại ở bước thứ mười bảy, nên cái chán đó thành thiết yếu. Mọi đội dựng agent rồi cũng đâm vào đúng bức tường này: chạy demo thì mượt, chạy thật một tuần thì mất trạng thái, retry sai, gọi trùng, và không ai biết nó đang ở bước nào. Theo Đức, đây là chỗ tách biệt rõ nhất giữa người làm AI theo phong trào và người làm hệ thống. Câu hỏi bạn nên tự hỏi khi thiết kế một agent không phải là dùng model nào, mà là nếu tiến trình chết ở bước thứ mười bảy thì chuyện gì xảy ra. Trả lời được câu đó thì bạn đã đi trước phần lớn thị trường, và bạn cũng hiểu vì sao một công ty làm durable execution lại được định giá hơn mười hai tỷ đô la.