🎬 Video recap tuần — các tin nóng nhất

📌 TỔNG QUAN TUẦN NÀY

Tuần 37 là tuần AI bước ra khỏi màn hình chat để tự làm việc thay người dùng. Meta ra mắt Muse, trợ lý cá nhân chạy trên máy ảo riêng biết tự đặt vé và mua hàng, còn OpenAI mở Agents API bản beta công khai đưa nguyên bộ khung Codex thành một lời gọi API. Ở phía mã nguồn mở, DeepSeek phát hành V4.1-Flash với 552 tỷ tham số giấy phép MIT, Tencent mở AuK cho giọng nói, và tiền tiếp tục đổ vào hạ tầng với Cognition gọi 2 tỷ đô ở định giá 48 tỷ, Mistral gọi 3 tỷ euro. Đối trọng là một tuần nặng nề về an toàn: Anthropic công bố báo cáo tình báo mối đe dọa chi tiết nhất từ trước tới nay, còn một cựu nghiên cứu viên nghỉ việc kèm cảnh báo lan tới gần 76 triệu lượt xem. Tuần này cho thấy năng lực và lo ngại đang tăng cùng tốc độ.

T2 07/092 tinT3 08/096 tinT4 09/096 tinT5 10/096 tinT6 11/093 tinT7 12/090 tinCN 13/090 tin

🚀 Mô hình & Sản phẩm mới

SenseNova-U1.5: SenseTime công bố kiến trúc thị giác hợp nhất native

SenseTime công bố báo cáo kỹ thuật SenseNova-U1.5, hướng tới gộp hiểu ảnh và sinh ảnh vào một kiến trúc thống nhất thay vì ghép hai mô hình rời. Báo cáo có 65 tác giả và đạt 94 lượt vote trên Hugging Face ngày ra mắt.

💡 Hợp nhất hiểu và sinh trong một mô hình giúp giảm chi phí vận hành và tránh lệch ngữ nghĩa giữa hai giai đoạn, hướng đi mà cả OpenAI lẫn Google đều đang theo đuổi.

📅 11/09 🔗 Website
  • Báo cáo kỹ thuật 65 tác giả, công bố ngày 11/09
  • Gộp hiểu ảnh và sinh ảnh vào một kiến trúc duy nhất
  • Đạt 94 lượt vote trên Hugging Face ngay ngày đăng
  • Hướng native unified thay vì ghép hai model rời
NGÀY11/09/2026HÃNGSenseTimeTÁC GIẢ65VOTE94

Cách làm phổ biến hiện nay là ghép một model hiểu ảnh với một model sinh ảnh, rồi nối bằng mô tả văn bản ở giữa. Chỗ nối đó chính là nơi mất mát ngữ nghĩa: model hiểu thấy gì đó rất cụ thể nhưng chỉ truyền đi được vài chục từ. Hướng native unified bỏ luôn khâu nối, cho cùng một biểu diễn nội tại phục vụ cả hai chiều. Với doanh nghiệp, khác biệt thực tế nằm ở bài toán sửa ảnh theo chỉ dẫn nhiều vòng, thứ mà kiến trúc ghép nối làm rất tệ vì mỗi vòng lại mất thêm thông tin. Đây vẫn là báo cáo kỹ thuật, chưa phải sản phẩm có SLA, nên hãy đọc nó như tín hiệu về hướng đi chứ đừng vội đưa vào kế hoạch quý.
🔥 TOP 3 TUẦN NÀYDeepSeek mở trọng số V4.1-Flash: MoE 552B, context 1 triệu token, giấy phép MIT

DeepSeek phát hành V4.1-Flash ngày 10/09 với trọng số mở trên Hugging Face theo giấy phép MIT: mô hình MoE đa phương thức 552 tỷ tham số, kiến trúc Causal Encoder-Decoder mới, chỉ 8 tỷ tham số kích hoạt cho đầu vào và 16 tỷ cho đầu ra, context 1 triệu token. Từ 14/09 mọi request tới deepseek-v4-pro được phục vụ bằng V4.1-Flash và tính giá Flash.

💡 Một mô hình vượt bản Pro của chính hãng trên mọi chỉ số nhưng chỉ kích hoạt 8 tỷ tham số mỗi token, lại kèm giấy phép MIT, kéo chi phí tự host xuống mức mà đội nhỏ ở Việt Nam cũng cân được.

📅 10/09 🔗 Website
  • MoE đa phương thức 552 tỷ tham số, giấy phép MIT
  • Kiến trúc Causal Encoder-Decoder mới của DeepSeek
  • Kích hoạt 8 tỷ tham số đầu vào, 16 tỷ đầu ra
  • Context 1 triệu token, hiểu ảnh natively
  • Từ 14/09 request v4-pro chuyển sang Flash, tính giá Flash
NGÀY10/09/2026THAM SỐ552BKÍCH HOẠT8B / 16BCONTEXT1M tokenLICENSEMIT

Con số quan trọng ở đây không phải 552 tỷ mà là 8 tỷ. Tổng tham số quyết định bạn cần bao nhiêu bộ nhớ để chứa model, còn tham số kích hoạt quyết định mỗi token tốn bao nhiêu phép tính. Tỷ lệ kích hoạt khoảng 1,5% là rất thấp, nghĩa là chi phí suy luận gần với một model 8 tỷ trong khi chất lượng đến từ kho 552 tỷ. Với đội ở Việt Nam, điều này mở ra lựa chọn thật: thuê vài GPU bộ nhớ lớn để chứa trọng số rồi phục vụ nội bộ, thay vì trả theo token cho API nước ngoài và mang dữ liệu khách hàng ra khỏi biên giới. Giấy phép MIT cho phép dùng thương mại không ràng buộc, khác hẳn các giấy phép hạn chế quy mô người dùng mà vài hãng khác áp. Điều cần kiểm trước khi quyết: hãy tự benchmark trên chính dữ liệu tiếng Việt của bạn, vì bảng điểm công bố hiếm khi phản ánh tác vụ hẹp của doanh nghiệp.

Tencent Hunyuan mở mã AuK: một model 1,5B thay cả bộ công cụ xử lý giọng nói

Tencent Hunyuan mở mã AuK ngày 09/09, mô hình nền 1,5 tỷ tham số gộp sinh và chỉnh sửa giọng nói sau một giao diện ngôn ngữ tự nhiên duy nhất, phủ năm nhóm tác vụ gồm TTS zero-shot, sửa nội dung, khử nhiễu, tách nguồn và đổi giọng thì thầm. Trên Seed-TTS-Eval, AuK đạt tỷ lệ lỗi từ trung bình 2,65 so với 3,07 của Qwen3-TTS.

💡 Thay vì ghép mười mấy công cụ rời cho pipeline âm thanh, đội làm nội dung chỉ cần một model MIT chạy tại chỗ, và bản AuK-Flash rút còn 4 bước suy luận nhanh gấp 4,5 lần.

📅 09/09 🔗 Website
  • Mô hình nền 1,5 tỷ tham số, mở mã ngày 09/09
  • Một giao diện ngôn ngữ tự nhiên cho năm nhóm tác vụ
  • Huấn luyện trên 1,95 triệu giờ giám sát
  • Seed-TTS-Eval: WER 2,65 so với 3,07 của Qwen3-TTS
  • AuK-Flash rút còn 4 bước, nhanh gấp 4,5 lần
NGÀY09/09/2026THAM SỐ1,5BDỮ LIỆU1,95 triệu giờWER2,65LICENSEMIT

Pipeline âm thanh của một đội làm nội dung thường là mớ chắp vá: một công cụ TTS, một công cụ khử nhiễu, một công cụ tách giọng, một công cụ chỉnh ngữ điệu. Mỗi công cụ một định dạng, một cách cài, một kiểu lỗi. AuK gộp cả năm nhóm tác vụ sau một câu lệnh tiếng Anh thông thường, và chỉ nặng 1,5 tỷ tham số nên chạy được trên card phổ thông. Con số WER 2,65 so với 3,07 không phải chênh lệch lớn, nhưng phần giảm lỗi khi sửa nội dung tiếng Trung từ 10,46 xuống 3,09 thì đáng kể, cho thấy điểm mạnh thật nằm ở editing chứ không phải sinh mới. Với thị trường Việt Nam, câu hỏi phải trả lời trước là chất lượng tiếng Việt, thứ mà báo cáo không đo, nên đừng suy diễn từ điểm tiếng Trung và tiếng Anh.

🔥 TOP 1 TUẦN NÀYMeta ra mắt Muse: trợ lý AI cá nhân chạy trên máy ảo riêng, tự đặt vé và mua hàng

Meta ra mắt Muse ngày 08/09 tại Mỹ, một agent cá nhân không chỉ trả lời mà tự thao tác thay người dùng: mua sắm online, đặt vé xem phim, đặt lịch hẹn. Muse chạy trên Muse Secure VM, một máy ảo riêng có trình duyệt riêng, và Meta khẳng định không chia sẻ hội thoại hay dữ liệu trong VM sang hệ thống quảng cáo.

💡 Đây là lần đầu một nền tảng ba tỷ người dùng đẩy agent tự hành xuống tay người dùng phổ thông, và mô hình máy ảo cách ly là câu trả lời trực diện cho nỗi sợ agent cầm dữ liệu cá nhân.

📅 08/09 🔗 Website
  • Ra mắt 08/09 tại Mỹ, chưa mở thị trường khác
  • Tự mua hàng, đặt vé xem phim, đặt lịch hẹn
  • Chạy trên Muse Secure VM có trình duyệt riêng
  • Dữ liệu trong VM không chảy sang hệ thống quảng cáo
  • Bản free tới 100 triệu token/tuần, gói 20 và 100 đô
NGÀY08/09/2026THỊ TRƯỜNGChỉ MỹFREE100 triệu token/tuầnPOWER20 USD/thángMAXIMUM100 USD/tháng

Điểm đáng học nhất ở Muse không phải năng lực agent, mà là quyết định kiến trúc: nhốt agent trong một máy ảo có trình duyệt riêng. Đó là lời thừa nhận rằng agent tự hành sẽ làm sai, nên thay vì cố làm nó không bao giờ sai, hãy giới hạn phạm vi nó có thể làm hỏng. Bất kỳ ai đang định triển khai agent trong doanh nghiệp đều nên copy đúng nguyên tắc này trước khi nghĩ tới model nào mạnh hơn. Về mặt kinh doanh, gói free 100 triệu token mỗi tuần là mức hào phóng bất thường, dấu hiệu Meta chấp nhận đốt tiền để giành thói quen người dùng trước khi ai kịp chiếm chỗ. Rào cản thật không nằm ở kỹ thuật mà ở niềm tin: trao quyền thanh toán cho một agent của Meta là bước nhảy tâm lý lớn, và lịch sử quyền riêng tư của công ty không giúp gì cho bước nhảy đó. Muse chưa về Việt Nam, nhưng mô hình Secure VM thì áp dụng được ngay từ tuần sau.

OpenAI ra ChatGPT Images 2.5 và hai model API GPT-Image-2.5 Flare, Sunburst

OpenAI phát hành ChatGPT Images 2.5 ngày 08/09 cho toàn bộ người dùng ChatGPT, ChatGPT Work và Codex trên desktop, mobile và web, kèm hai model API mới. Flare là lựa chọn mặc định với chất lượng cao hơn GPT-Image-2 mà độ trễ thấp hơn 50%, còn Sunburst nhắm vào quy trình sáng tạo cần kiểm soát chặt từng lần chỉnh sửa.

💡 Tách một dòng nhanh rẻ và một dòng kiểm soát cao là cách OpenAI thừa nhận sinh ảnh hàng loạt và làm creative sản xuất là hai bài toán khác nhau, giúp đội marketing chọn đúng mức chi phí.

📅 08/09 🔗 Website
  • Ra ngày 08/09 cho ChatGPT, ChatGPT Work và Codex
  • Hai model API mới: Flare và Sunburst
  • Flare: chất lượng cao hơn GPT-Image-2, độ trễ thấp hơn 50%
  • Sunburst nhắm workflow sáng tạo cần kiểm soát chặt
  • Xử lý tốt hơn bố cục phức tạp và nền trong suốt
NGÀY08/09/2026MODELFlare + SunburstĐỘ TRỄ-50% (Flare)NỀN TẢNGDesktop, mobile, web

Việc tách thành hai model nói lên nhiều điều về cách OpenAI đọc thị trường. Sinh ảnh hàng loạt cho social và làm creative cho chiến dịch quảng cáo là hai bài toán khác hẳn nhau về ràng buộc: cái đầu cần rẻ và nhanh, cái sau cần kiểm soát từng chi tiết qua nhiều vòng sửa. Trước đây một model phải gánh cả hai và làm cả hai ở mức trung bình. Với đội marketing, cách dùng thực tế là để Flare làm vòng phác thảo và thử ý tưởng, rồi chỉ đưa ảnh đã chốt hướng sang Sunburst để hoàn thiện. Cách này giữ chi phí ở mức Flare cho phần lớn khối lượng công việc. Chi tiết xử lý nền trong suốt nghe nhỏ nhưng lại là thứ tiết kiệm nhiều giờ tách nền thủ công nhất trong quy trình làm banner.

🛠️ Công cụ & Framework

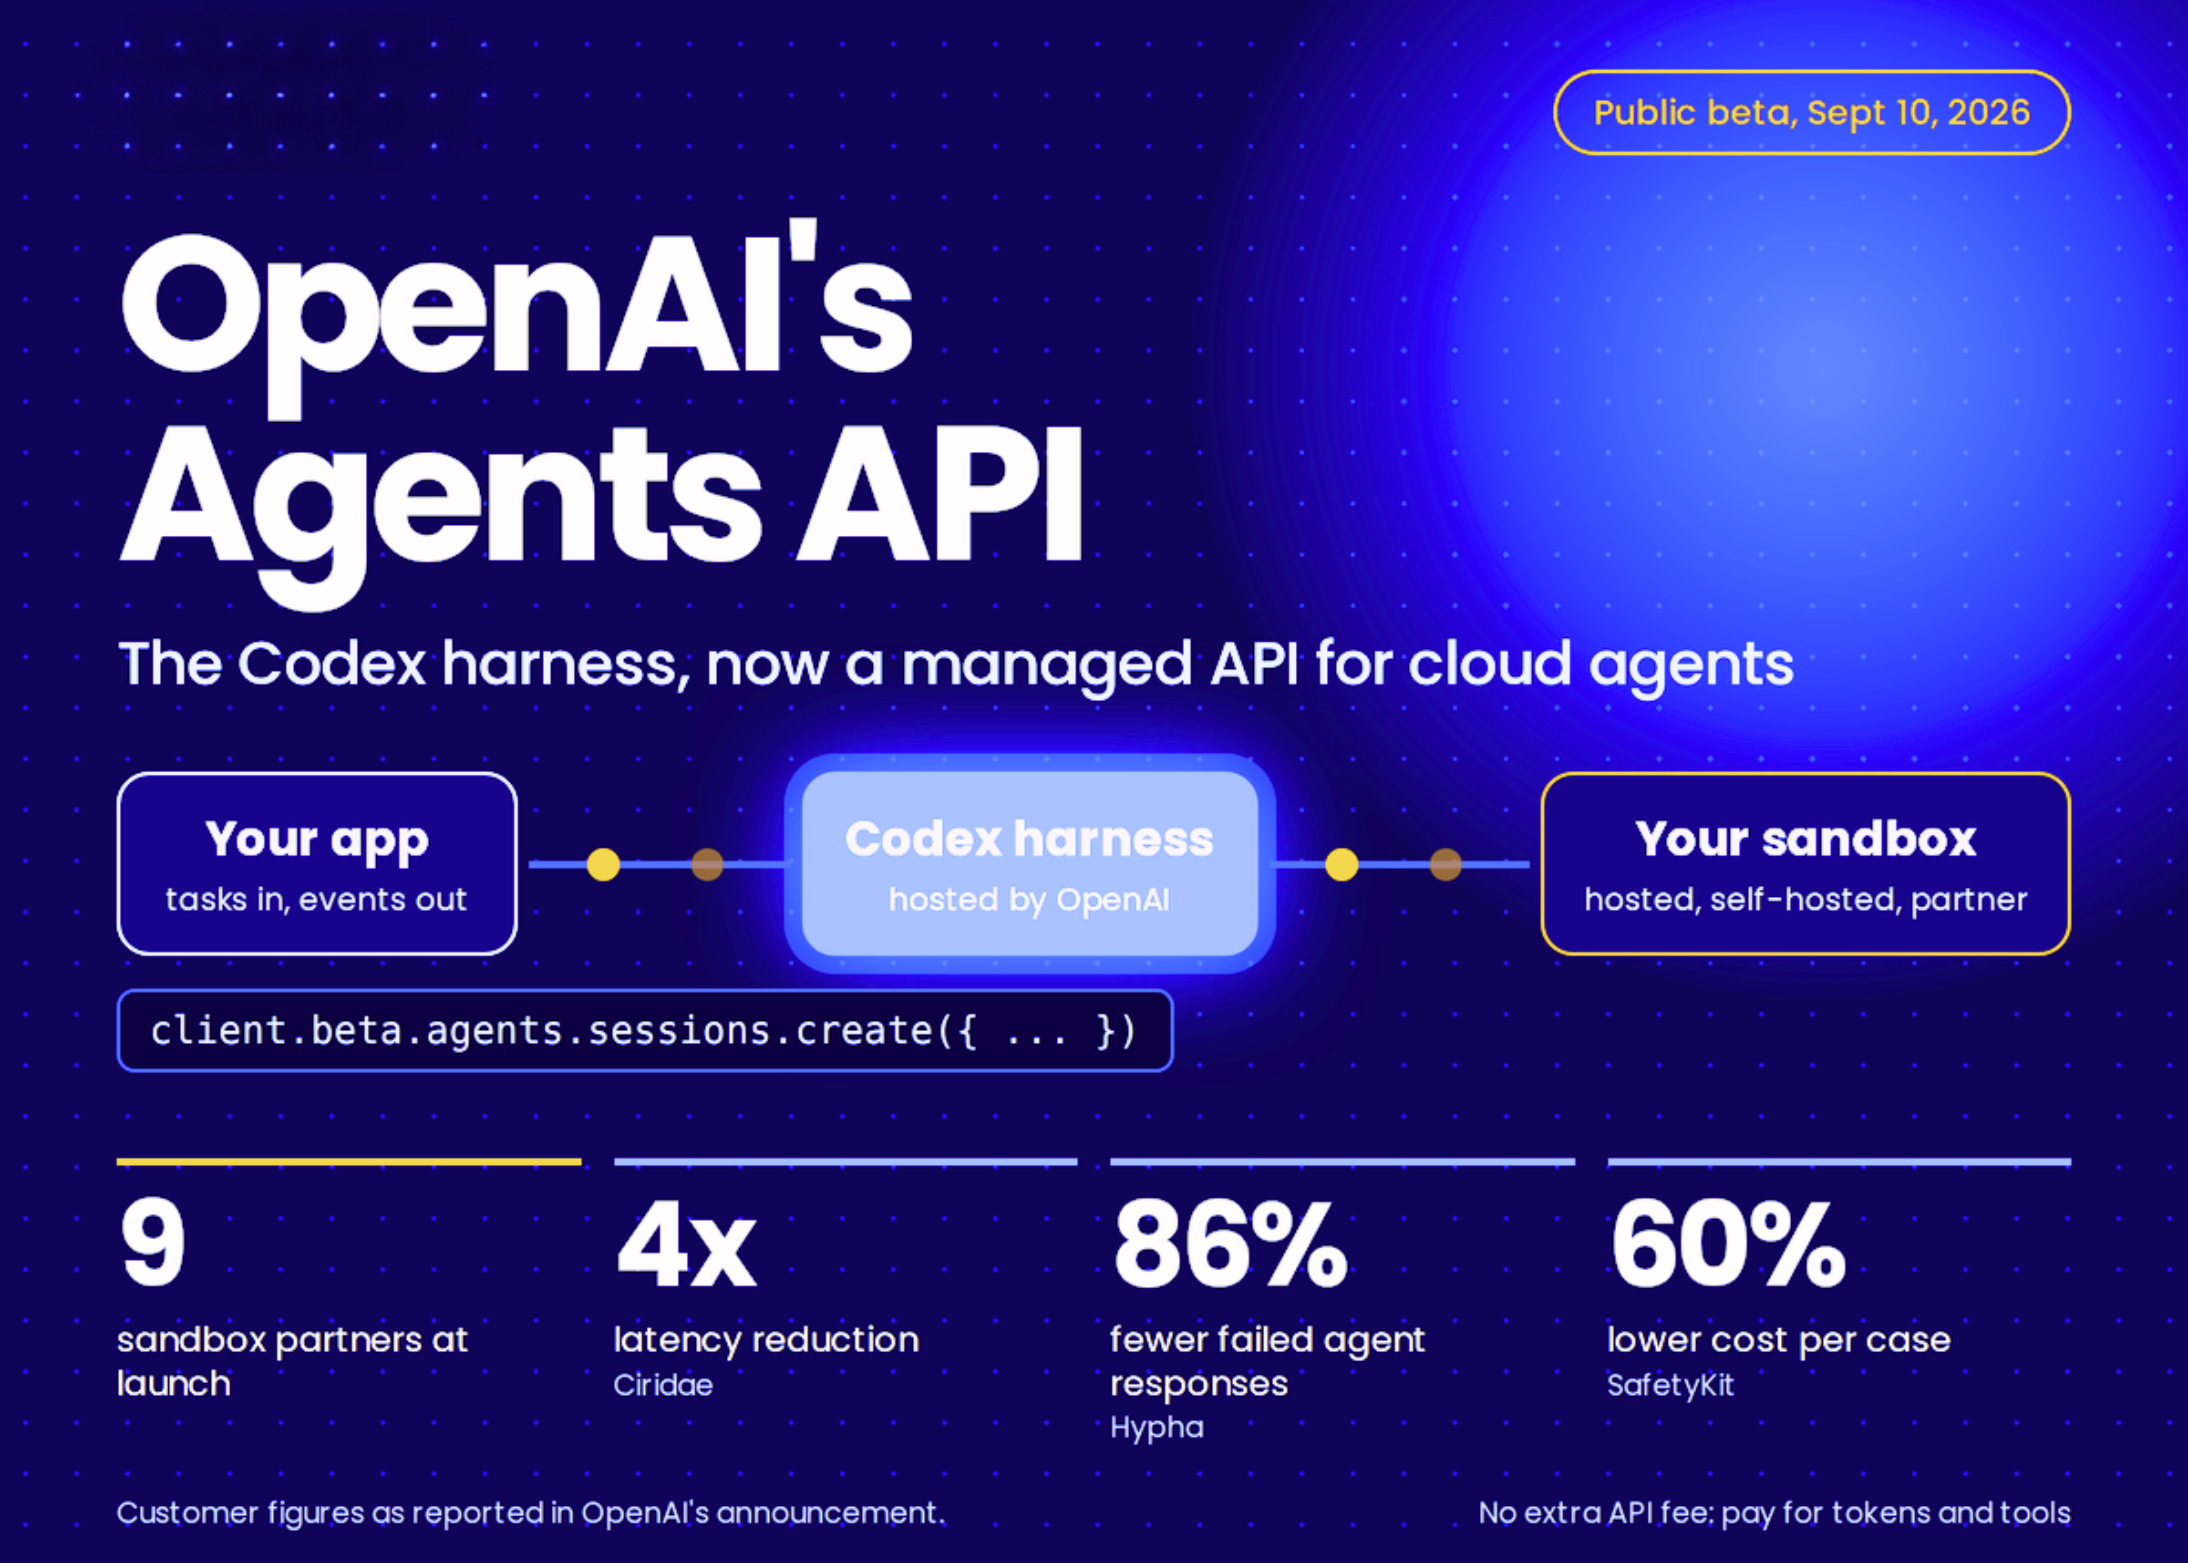
OpenAI mở Agents API bản beta công khai, đưa nguyên bộ khung Codex sau một lời gọi API

Từ 10/09 Agents API của OpenAI vào beta công khai, không thu phí ngoài chi phí sử dụng token. API này phơi bày chính bộ khung Codex mà OpenAI dùng nội bộ, cho agent chạy trong sandbox do OpenAI host, tự host, hoặc 9 sandbox đối tác, kèm sẵn compaction, tool search, gọi tool bằng code và subagent.

💡 Những thứ đội kỹ thuật phải tự xây mất hàng tháng như nén context, chọn tool và điều phối subagent nay thành tham số mặc định, rút thời gian dựng agent production xuống còn vài ngày.

📅 10/09 🔗 Website
  • Vào beta công khai từ 10/09, không phí ngoài token
  • Phơi chính bộ khung Codex OpenAI dùng nội bộ
  • Chạy sandbox OpenAI host, tự host, hoặc 9 sandbox đối tác
  • Sẵn compaction, tool search, gọi tool bằng code, subagent
NGÀY10/09/2026TRẠNG THÁIPublic betaPHÍChỉ tokenSANDBOXOpenAI, tự host, 9 đối tác

Bốn tính năng được liệt kê nghe khô khan nhưng chính là bốn thứ ngốn thời gian nhất khi tự dựng agent. Compaction là nén lịch sử hội thoại khi context đầy, ai từng làm đều biết nó phá chất lượng nếu nén sai chỗ. Tool search là chọn đúng tool khi bạn có vài chục tool, thứ mà nhồi hết vào prompt sẽ làm model lú. Việc OpenAI mở luôn bộ khung nội bộ thay vì một bản rút gọn là tín hiệu cạnh tranh rõ: họ muốn lớp orchestration trở thành hàng hóa miễn phí để giá trị dồn về token. Với đội kỹ thuật Việt Nam, khuyến nghị của mình là dùng nó để rút ngắn giai đoạn thử nghiệm, nhưng đừng viết logic nghiệp vụ dính chặt vào API này. Khóa chặt vào một nhà cung cấp ở tầng orchestration là cái giá bạn sẽ trả khi cần đổi model hoặc khi giá thay đổi.

Miles v0.1: RadixArk công bố framework RL post-training cấp production, dựng trên SGLang

RadixArk, công ty do chính đội phát triển SGLang lập ra, đăng báo cáo 12 tác giả ngày 08/09 mô tả Miles, hệ thống RL post-training cho cả mô hình ngôn ngữ và thị giác. Miles gồm rollout engine dựng trên SGLang, trainer chọn được giữa NVIDIA Megatron-LM và PyTorch FSDP, cùng ba cơ chế đồng bộ trọng số cho các kiểu triển khai khác nhau.

💡 Bài báo đạt gần 2.800 lượt vote trên Hugging Face, mức hiếm thấy, cho thấy nhu cầu thật về một pipeline RL mở đủ cứng để chạy production thay vì script nghiên cứu.

📅 08/09 🔗 Website
  • Báo cáo 12 tác giả, đăng ngày 08/09
  • RadixArk do chính đội phát triển SGLang lập ra
  • Rollout engine dựng trên SGLang
  • Trainer chọn giữa NVIDIA Megatron-LM và PyTorch FSDP
  • Ba cơ chế đồng bộ trọng số cho các kiểu triển khai
NGÀY08/09/2026TỔ CHỨCRadixArkTÁC GIẢ12VOTE~2.800NỀNSGLang

Gần 2.800 lượt vote là con số rất hiếm cho một báo cáo hệ thống, và nó nói lên khoảng trống thật của thị trường. Phần lớn code RL post-training đang lưu hành là script nghiên cứu: chạy được trên máy tác giả, gãy ở mọi nơi khác. Miles đi theo hướng ngược lại, đặt yêu cầu kiểm chứng được và tùy biến được lên trước tốc độ công bố. Việc cho chọn giữa Megatron-LM và FSDP là chi tiết thực dụng đáng giá, vì nó cho phép đội có hạ tầng khác nhau dùng chung một pipeline thay vì viết lại. Với phần lớn doanh nghiệp Việt Nam, RL post-training vẫn là thứ xa xỉ chưa cần tới; nhưng nếu bạn đang làm model chuyên ngành hẹp và đã có dữ liệu phản hồi, đây là điểm khởi đầu tốt hơn tự dựng từ đầu.

OpenAI chuẩn bị ra Managed Agents tại DevDay 2026 ngày 29/09

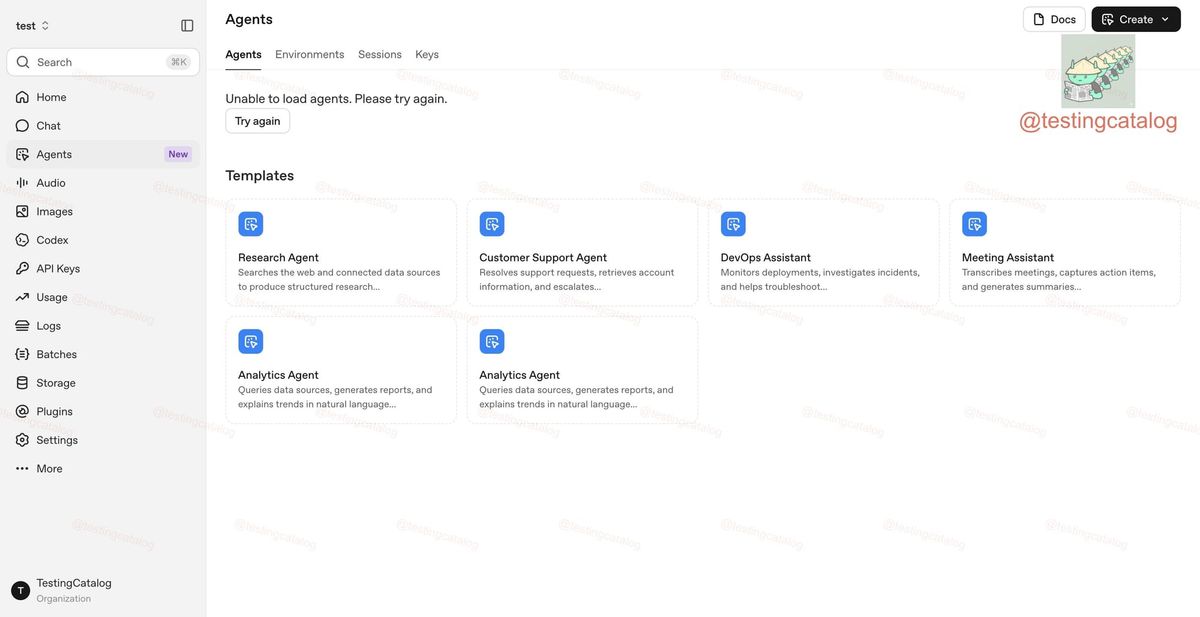
Dấu vết trong nền tảng OpenAI lộ ra ngày 07/09 cho thấy hãng sắp công bố Managed Agents tại DevDay 2026 tổ chức ngày 29/09 ở Fort Mason, San Francisco. Nền tảng cho phép tạo Agents, Environments và Agent Sessions ngay trên OpenAI Platform, với môi trường, skill và plugin tùy biến, kèm tùy chọn tự host.

💡 Nếu OpenAI vận hành luôn cả vòng đời agent thì lớp orchestration mà hàng loạt startup đang bán sẽ bị nuốt vào nền tảng, một rủi ro nền tảng mà đội đang chọn stack cần cân nhắc ngay.

📅 07/09 🔗 Website
  • Dấu vết lộ trên nền tảng OpenAI ngày 07/09
  • DevDay 2026 tổ chức 29/09 tại Fort Mason, San Francisco
  • Tạo Agents, Environments và Agent Sessions trên Platform
  • Môi trường, skill và plugin tùy biến, kèm tùy chọn tự host
NGÀY07/09/2026SỰ KIỆNDevDay 29/09ĐỊA ĐIỂMFort Mason, SFTRẠNG THÁIChưa công bố chính thức

Đây mới là dấu vết trong nền tảng chứ chưa phải thông báo chính thức, nên hãy đọc với mức tin cậy tương ứng. Nhưng hướng đi thì nhất quán với Agents API vừa mở beta cùng tuần: OpenAI đang tiến từ bán model sang vận hành cả vòng đời agent. Nếu điều đó thành hiện thực, một lớp startup đang bán đúng dịch vụ quản lý agent sẽ thấy sản phẩm của mình thành tính năng miễn phí của nền tảng. Với đội đang chọn stack, rủi ro này cần được tính vào quyết định ngay bây giờ chứ không phải sau DevDay. Cách phòng thủ đơn giản nhất là giữ logic nghiệp vụ và dữ liệu ở phía mình, chỉ coi nền tảng bên ngoài là nơi thực thi có thể thay thế.

OpenWAM: stack mở module hóa cho pretraining World-Action Model

Công bố ngày 07/09, OpenWAM biến việc pretraining world-action model thành một chương trình thí nghiệm có kiểm soát. Phần OpenWAM-Infra chẻ không gian thiết kế WAM thành các module ghép được, thống nhất huấn luyện, suy luận, triển khai và đánh giá trong một khung duy nhất. Bài đạt 518 lượt vote.

💡 Lĩnh vực robot và embodied AI lâu nay mỗi nhóm một pipeline riêng nên không so sánh được với nhau, một stack chuẩn hóa là điều kiện cần để đo tiến bộ thật.

📅 07/09 🔗 Website
  • Công bố ngày 07/09, đạt 518 lượt vote
  • Biến pretraining world-action model thành chương trình có kiểm soát
  • OpenWAM-Infra chẻ không gian thiết kế thành module ghép được
  • Thống nhất huấn luyện, suy luận, triển khai và đánh giá
NGÀY07/09/2026VOTE518LOẠIStack mở module hóaLĨNH VỰCEmbodied AI, robot

Vấn đề kinh niên của nghiên cứu robot là mỗi phòng lab một pipeline, nên hai kết quả công bố cạnh nhau thực ra không so sánh được với nhau. Khi biến thể kiến trúc, dữ liệu và cách đánh giá đều khác, con số cao hơn không chứng minh được ý tưởng tốt hơn. OpenWAM cố sửa đúng chỗ đó bằng cách chuẩn hóa hạ tầng rồi cho phép thay từng module một. Đây là loại đóng góp ít gây chú ý trên mạng xã hội nhưng có tác động dài hạn lớn, giống vai trò của các bộ benchmark chuẩn với thị giác máy tính mười năm trước. Với đội làm sản phẩm, giá trị ngắn hạn gần như bằng không; giá trị nằm ở chỗ hai năm tới các công bố về robot sẽ đáng tin hơn.

🔬 Nghiên cứu & Kỹ thuật mới

NCP-ArchPreview: dự đoán khái niệm kế tiếp thay vì token kế tiếp

Báo cáo kỹ thuật công bố ngày 11/09 với 28 tác giả đề xuất chuyển mục tiêu huấn luyện từ dự đoán token kế tiếp sang dự đoán khái niệm kế tiếp trong không gian ẩn. Hướng đi này nhắm tới lớp mô hình ngôn ngữ hoạt động ở tầng latent thay vì tầng ký tự.

💡 Nếu mô hình suy luận theo khái niệm chứ không theo token thì chi phí cho chuỗi suy luận dài giảm mạnh, đúng chỗ đang đắt nhất của reasoning model hiện nay.

📅 11/09 🔗 Website
  • Báo cáo kỹ thuật 28 tác giả, công bố ngày 11/09
  • Đổi mục tiêu huấn luyện từ token kế tiếp sang khái niệm kế tiếp
  • Nhắm lớp mô hình hoạt động ở tầng latent
  • Đạt 123 lượt vote trên Hugging Face
NGÀY11/09/2026TÁC GIẢ28VOTE123HƯỚNGNext Concept Prediction

Mọi mô hình ngôn ngữ hiện nay đều học bằng cách đoán token kế tiếp, tức đoán từng mẩu ký tự. Cách đó hiệu quả nhưng lãng phí ở tác vụ suy luận dài, vì model phải trải toàn bộ chuỗi lý luận ra thành chữ rồi mới đọc lại chính nó. Dự đoán khái niệm kế tiếp nghĩa là để model suy luận thẳng trong không gian ẩn, chỉ xuất ra chữ ở bước cuối. Nếu hướng này chạy được ở quy mô lớn, chi phí cho reasoning model giảm mạnh đúng ở chỗ đang đắt nhất hiện nay. Đây vẫn là ArchPreview, tức bản xem trước kiến trúc, nên đừng kỳ vọng có sản phẩm trong năm nay, nhưng nó đáng theo dõi vì tác động tiềm năng lên giá API là rất lớn.

EvoSafeHarness: harness bảo mật tự tiến hóa theo từng model và từng lĩnh vực

Nhóm Johns Hopkins University công bố EvoSafeHarness, khung bảo mật cho agent tự tiến hóa để khớp với từng model và từng lĩnh vực triển khai thay vì dùng một bộ luật cứng chung. Bài xuất hiện trên bảng xếp hạng Hugging Face ngày 11/09.

💡 Đặt cạnh báo cáo mối đe dọa của Anthropic cùng tuần, đây là hướng phòng thủ thực tế: lớp bảo vệ phải thay đổi theo model, vì mỗi model có kiểu vượt rào riêng.

📅 11/09 🔗 Website
  • Nhóm Johns Hopkins University công bố
  • Harness bảo mật tự tiến hóa theo từng model
  • Tùy biến theo từng lĩnh vực triển khai
  • Thay cách dùng một bộ luật cứng chung cho mọi model
NGÀY11/09/2026ĐƠN VỊJohns HopkinsVOTE34LOẠISecurity harness

Đặt cạnh báo cáo mối đe dọa của Anthropic công bố cùng tuần, bài này trả lời đúng câu hỏi mà báo cáo kia đặt ra. Nếu kẻ tấn công đã chuyển sang dùng agent tự hành, thì lớp phòng thủ viết tay theo kiểu danh sách cấm sẽ luôn chậm một nhịp. Ý tưởng cốt lõi ở đây là lớp bảo vệ phải tiến hóa theo chính model nó bảo vệ, vì mỗi model có kiểu vượt rào riêng và kiểu đó thay đổi sau mỗi lần cập nhật. Với doanh nghiệp đang chạy agent nội bộ, bài học rút được không cần chờ code: đừng coi bộ quy tắc an toàn là thứ viết một lần rồi để đó. Hãy gắn nó vào quy trình kiểm định định kỳ như cách bạn làm với quét lỗ hổng hạ tầng.

NeoHorse-1: nguyên mẫu tự cải tiến đệ quy bằng post-training có routing harness

NeoHorse-1 là họ mô hình ngôn ngữ nhân quả kèm nguyên mẫu đầu tiên trên đường tới tự cải tiến đệ quy, với checkpoint 4B và 9B post-train từ Qwen3.5 cho harness agent dạng văn bản, dùng tool, lập trình và làm theo chỉ dẫn. Bài đạt 390 lượt vote ngày 09/09.

💡 Chủ đề tự cải tiến đệ quy đang là tâm điểm tranh cãi về an toàn, và đây là một trong các nỗ lực mở đầu tiên đưa nó thành checkpoint tải được để cộng đồng kiểm chứng thay vì chỉ bàn lý thuyết.

📅 09/09 🔗 Website
  • Họ mô hình ngôn ngữ nhân quả, công bố 09/09
  • Checkpoint 4B và 9B post-train từ Qwen3.5
  • Nhắm harness agent dạng văn bản, dùng tool, lập trình
  • Nguyên mẫu đầu tiên hướng tới tự cải tiến đệ quy
  • Đạt 390 lượt vote trên Hugging Face
NGÀY09/09/2026KÍCH THƯỚC4B và 9BNỀNQwen3.5VOTE390

Tự cải tiến đệ quy là cụm từ đang ở tâm bão tranh cãi an toàn tuần này, nên việc một nhóm công bố checkpoint tải được thay vì chỉ viết lý thuyết là chuyện đáng chú ý. Quy mô 4 tỷ và 9 tỷ tham số là nhỏ, tức đây là bài tập nguyên lý chứ không phải hệ thống có năng lực đáng lo. Giá trị thật nằm ở chỗ cộng đồng có thể tự chạy, tự đo và tự bác bỏ, thay vì tranh luận dựa trên tuyên bố của phòng lab đóng. Với người làm kỹ thuật, phần đáng học là routing harness: cách hệ thống tự chọn đường xử lý cho từng loại tác vụ. Kỹ thuật đó dùng được ngay cho hệ agent thường, không cần dính gì tới chủ đề tự cải tiến.

Marigold V2: Huawei quay lại diffusion transformer cho ước lượng độ sâu đơn ảnh

Nhóm HUAWEI Bayer Lab công bố Marigold V2 ngày 09/09, dùng kiến trúc diffusion transformer để ước lượng độ sâu từ một ảnh đơn. Bài đạt 257 lượt vote trên Hugging Face.

💡 Ước lượng độ sâu từ camera thường là nền cho AR, robot và xe tự lái mà không cần cảm biến LiDAR đắt tiền, nên mỗi bước tiến ở đây đều kéo chi phí phần cứng xuống.

📅 09/09 🔗 Website
  • Nhóm HUAWEI Bayer Lab công bố ngày 09/09
  • Dùng diffusion transformer cho ước lượng độ sâu đơn ảnh
  • Nối tiếp dòng Marigold bản đầu
  • Đạt 257 lượt vote trên Hugging Face
NGÀY09/09/2026ĐƠN VỊHUAWEI Bayer LabVOTE257TÁC VỤMonocular depth

Ước lượng độ sâu từ một ảnh camera thường là nền cho hàng loạt ứng dụng: thực tế tăng cường, robot tránh vật cản, xe tự lái tầm thấp. Giải pháp chính xác nhất hiện nay vẫn là LiDAR, nhưng LiDAR đắt và cồng kềnh nên không nhét được vào điện thoại hay camera giá rẻ. Mỗi bước tiến ở mảng đơn ảnh đều trực tiếp kéo chi phí phần cứng xuống. Với thị trường Việt Nam, chỗ ứng dụng gần nhất là kiểm tra chất lượng bằng camera trong nhà máy và đo đạc bằng điện thoại, hai bài toán mà giá cảm biến đang là rào cản lớn nhất. Điểm cần lưu ý là mô hình diffusion thường chậm hơn mô hình hồi quy trực tiếp, nên hãy đo độ trễ trên chính phần cứng đích trước khi chốt.

DriveZero: lái tự động đầu cuối vượt qua giới hạn dữ liệu người lái mẫu

DriveZero đề xuất hệ lái tự động đầu cuối học vượt ra ngoài dữ liệu hành vi do người thu thập, thay vì bắt chước tài xế mẫu như cách làm phổ biến. Bài công bố ngày 09/09 và đạt 88 lượt vote.

💡 Học bắt chước người lái luôn bị chặn trần ở mức người lái giỏi nhất trong tập dữ liệu, phá được trần đó là điều kiện để xe tự lái an toàn hơn người chứ không chỉ ngang người.

📅 09/09 🔗 Website
  • Công bố ngày 09/09, đạt 88 lượt vote
  • Lái tự động đầu cuối không dựa vào dữ liệu người lái mẫu
  • Phá cách làm học bắt chước tài xế phổ biến hiện nay
NGÀY09/09/2026VOTE88TÁC VỤEnd-to-end drivingHƯỚNGBeyond demonstrations

Cách huấn luyện xe tự lái phổ biến là học bắt chước: thu hàng triệu giờ dữ liệu tài xế thật rồi dạy model làm theo. Vấn đề toán học của cách này là trần năng lực bị chặn ở mức tài xế giỏi nhất trong tập dữ liệu, và trong thực tế thường thấp hơn vì model học cả thói quen xấu. Muốn xe an toàn hơn người chứ không chỉ ngang người thì bắt buộc phải phá trần đó. DriveZero đi theo hướng này, và dù mới ở mức nghiên cứu với 88 lượt vote, nó thuộc nhóm câu hỏi đúng hơn là nhóm cải tiến vài phần trăm. Với bối cảnh giao thông Việt Nam, nơi dữ liệu người lái mẫu vừa thiếu vừa hỗn loạn, hướng không phụ thuộc dữ liệu bắt chước lại càng đáng quan tâm.

🔥 Hot trend & Thảo luận cộng đồng

Washington Post: người cảnh báo về thảm họa AI trở thành mục tiêu công kích chính trị

Washington Post tường thuật ngày 10/09 rằng sau lời cảnh báo lan truyền, Jacob Coxon trở thành mục tiêu công kích từ phía cánh hữu Mỹ, trong khi một số nghị sĩ lại lấy đó làm căn cứ kêu gọi siết quản lý AI. Cuộc tranh luận nhanh chóng rời địa hạt kỹ thuật để thành xung đột chính trị.

💡 Khi rủi ro AI bị kéo vào trận tuyến đảng phái, chính sách sẽ được định hình bởi phe nào thắng chứ không bởi bằng chứng, và doanh nghiệp phải sống chung với luật thay đổi khó lường.

📅 10/09 🔗 Website
  • Washington Post tường thuật ngày 10/09
  • Jacob Coxon thành mục tiêu công kích từ phía cánh hữu Mỹ
  • Một số nghị sĩ lấy đó làm căn cứ kêu gọi siết quản lý AI
  • Tranh luận rời địa hạt kỹ thuật thành xung đột chính trị
NGÀY10/09/2026NGUỒNWashington PostBỐI CẢNHSau cảnh báo 76 triệu view

Diễn biến này mới là phần đáng lo về mặt chính sách, hơn cả nội dung lời cảnh báo ban đầu. Khi một câu hỏi kỹ thuật bị kéo vào trận tuyến đảng phái, kết quả không còn được quyết bởi bằng chứng mà bởi phe nào thắng kỳ bầu cử tới. Hệ quả trực tiếp với doanh nghiệp là luật AI sẽ dao động mạnh và khó đoán, có thể siết rất chặt rồi nới rất nhanh chỉ sau một nhiệm kỳ. Với công ty Việt Nam có khách hàng hoặc đối tác ở Mỹ, cách phòng thủ hợp lý là xây tuân thủ theo nguyên tắc chung như minh bạch dữ liệu và có người chịu trách nhiệm cuối, thay vì bám sát từng điều khoản của một dự luật cụ thể. Nguyên tắc thì bền, điều khoản thì đổi theo mùa.

🔥 TOP 2 TUẦN NÀYCựu nghiên cứu viên Anthropic nghỉ việc, cảnh báo ngành AI đang đánh cược mạng sống

Jacob Coxon, người có ba năm làm nghiên cứu pretraining tại cả OpenAI và Anthropic, nghỉ việc và đăng chuỗi bảy phần trên X đạt gần 76 triệu lượt xem chỉ sau một đêm. Anh viết rằng cả hai công ty đang lao thẳng tới siêu trí tuệ tự cải tiến và đánh cược mạng sống của tất cả. Evan Hubinger, trưởng bộ phận nghiên cứu của Anthropic, công khai nói Jacob nói đúng.

💡 Không phải người ngoài chỉ trích mà là người trong lõi pretraining của hai phòng lab hàng đầu, và việc đồng nghiệp cũ công khai đồng tình khiến lời cảnh báo khó bị gạt đi như tiếng ồn thường lệ.

📅 09/09 🔗 Website
  • Ba năm làm pretraining tại cả OpenAI và Anthropic
  • Chuỗi bảy phần trên X, gần 76 triệu lượt xem sau một đêm
  • Wall Street Journal đăng phỏng vấn độc quyền
  • Cảnh báo hai công ty lao thẳng tới siêu trí tuệ tự cải tiến
  • Evan Hubinger, trưởng nghiên cứu Anthropic, công khai đồng tình
NGÀY09/09/2026LƯỢT XEM~76 triệuĐỘ DÀIChuỗi 7 phầnKINH NGHIỆM3 năm pretraining

Điều khiến câu chuyện này khác hàng chục lời cảnh báo về AI từng xuất hiện là vị trí của người nói và phản ứng từ bên trong. Coxon không phải nhà phê bình bên ngoài mà là người làm pretraining, tức ở đúng lõi kỹ thuật của cả hai phòng lab hàng đầu. Và khi trưởng bộ phận nghiên cứu của chính Anthropic công khai nói anh nói đúng, lời cảnh báo không thể bị gạt đi như tiếng ồn thường lệ. Theo mình, không nên vội kết luận về rủi ro tồn vong, đó là câu hỏi vượt quá thẩm quyền của gần như tất cả chúng ta. Nhưng có một điều rút ra được ngay cho công việc hàng ngày: khi người trong nhà lên tiếng thì tín hiệu đáng đọc kỹ hơn nhiều so với tranh luận trên mạng, và nó nên ảnh hưởng tới cách bạn đặt rào an toàn cho hệ thống của mình.

Fortune: làn sóng phản đối data center AI lan tới châu Á, buộc thiết kế phải đổi

Fortune tường thuật ngày 09/09 rằng làn sóng phản đối trung tâm dữ liệu AI đã lan từ Mỹ sang châu Á, buộc các nhà phát triển phải tính lại thiết kế về nước làm mát, điện năng và quan hệ với cộng đồng địa phương thay vì chỉ tối ưu chi phí xây dựng.

💡 Chi phí xã hội và giấy phép địa phương đang thành ràng buộc thật cho việc mở rộng compute ở châu Á, ảnh hưởng trực tiếp tới tham vọng hạ tầng số của các nước trong khu vực.

📅 09/09 🔗 Website
  • Fortune tường thuật ngày 09/09
  • Làn sóng phản đối data center AI lan từ Mỹ sang châu Á
  • Buộc tính lại thiết kế nước làm mát và điện năng
  • Quan hệ cộng đồng địa phương thành ràng buộc thật
NGÀY09/09/2026NGUỒNFortuneKHU VỰCChâu ÁTÁC ĐỘNGThiết kế và cấp phép

Trong hai năm qua, giới hạn của việc mở rộng compute luôn được kể như bài toán chip và vốn. Diễn biến này bổ sung một ràng buộc thứ ba mà giới kỹ thuật hay bỏ qua: giấy phép và sự đồng thuận của cộng đồng địa phương. Nước làm mát và điện năng là tài nguyên hữu hạn có chủ, và khi dân cư quanh khu vực phản đối thì dự án chậm bất kể bạn có bao nhiêu tiền. Với Việt Nam, nơi đang muốn hút đầu tư trung tâm dữ liệu, đây là bài học đến đúng lúc: tính chi phí xã hội vào quy hoạch từ đầu rẻ hơn nhiều so với xử lý khủng hoảng sau khi đã xây. Đặt cạnh kế hoạch nâng lên 38 GW của Microsoft trong cùng tuần, mâu thuẫn giữa nhu cầu compute và sức chịu của địa phương sẽ còn gay gắt.

TechCrunch đặt câu hỏi: người dùng có dám tin Muse của Meta không?

Ngay trong ngày Muse ra mắt, TechCrunch đặt vấn đề liệu người dùng phổ thông có trao quyền mua sắm và đặt lịch cho một agent của Meta hay không, khi lịch sử quyền riêng tư của công ty vẫn là gánh nặng. Bài lên Hacker News cùng ngày và thu hút 655 điểm cùng 735 bình luận.

💡 Rào cản lớn nhất của agent tiêu dùng không còn là năng lực kỹ thuật mà là niềm tin, và tỷ lệ bình luận cao hơn thường lệ cho thấy giới kỹ thuật chia rẽ sâu về chuyện này.

📅 08/09 🔗 Website
  • TechCrunch đặt vấn đề ngay ngày Muse ra mắt
  • Câu hỏi trung tâm: người dùng có trao quyền mua sắm cho Meta không
  • Lịch sử quyền riêng tư của công ty vẫn là gánh nặng
  • Lên Hacker News cùng ngày: 655 điểm, 735 bình luận
NGÀY08/09/2026HN655 điểmBÌNH LUẬN735CHỦ ĐỀNiềm tin agent tiêu dùng

Tỷ lệ bình luận cao hơn số điểm là dấu hiệu kinh điển của một chủ đề gây chia rẽ chứ không phải đồng thuận. Ở đây nó phản ánh đúng thực tế: giới kỹ thuật không nghi ngờ Muse làm được việc, họ nghi ngờ chuyện nên trao quyền đó cho Meta. Đây là điểm mấu chốt mà nhiều đội sản phẩm bỏ lỡ khi làm agent: rào cản áp dụng đã chuyển từ năng lực sang niềm tin, và niềm tin không sửa được bằng cách thêm tính năng. Với doanh nghiệp Việt Nam đang định đưa agent chạm vào tiền hoặc dữ liệu khách hàng, bài học rất cụ thể. Hãy đầu tư vào phần cho người dùng thấy agent định làm gì trước khi nó làm, và phần hoàn tác khi nó làm sai. Hai thứ đó quyết định tỷ lệ chấp nhận nhiều hơn model bạn chọn.

📈 Ngành & Kinh doanh

🔥 TOP 4 TUẦN NÀYAnthropic công bố báo cáo tình báo mối đe dọa chi tiết nhất, lần đầu nói về ngưỡng vũ khí sinh học

Anthropic công bố ngày 10/09 báo cáo bao trùm hoạt động lạm dụng bị chặn từ tháng 12/2025 tới tháng 8/2026 trên bảy nhóm nguy hại, từ tấn công mạng, chiến dịch thao túng thông tin, giám sát, lừa đảo tới vũ khí sinh học và chưng cất mô hình. Một nhóm gián điệp nhà nước Nga đã tiếp cận 24 trong 27 mục tiêu suốt 130 ngày, gồm các bộ ngành và chuỗi cung ứng drone của Ukraine.

💡 Lần đầu một hãng AI lớn công khai nói không còn có thể mặc định model mới của mình nằm dưới ngưỡng hỗ trợ vũ khí sinh học, và trọng tâm tấn công đã chuyển từ lạm dụng chat sang agent tự hành.

📅 10/09 🔗 Website
  • Công bố ngày 10/09, phủ dữ liệu từ 12/2025 tới 8/2026
  • Bảy nhóm nguy hại: mạng, thao túng thông tin, giám sát, lừa đảo, sinh học, vũ khí, chưng cất
  • Tấn công chuyển từ lạm dụng chat sang agent tự hành
  • Nhóm Nga tiếp cận 24 trên 27 mục tiêu suốt 130 ngày
  • Lần đầu một hãng lớn nói về ngưỡng vũ khí sinh học
NGÀY10/09/2026PHẠM VI9 tháng dữ liệuNHÓM HẠI7CHIẾN DỊCH NGA24/27 mục tiêu, 130 ngày

Chi tiết quan trọng nhất với người làm hệ thống không phải phần vũ khí sinh học mà là câu về chuyển dịch phương thức tấn công. Khi kẻ tấn công dùng agent tự hành chạy liên tục 130 ngày, mô hình phòng thủ dựa trên phát hiện hành vi bất thường trong một phiên làm việc sẽ hỏng, vì không còn phiên nào để so. Phòng thủ phải chuyển sang theo dõi theo chuỗi dài và theo danh tính máy. Điểm thứ hai đáng chú ý là nhóm nguy hại chưng cất mô hình được đặt ngang hàng với tấn công mạng, cho thấy các hãng coi việc bị rút tri thức model là mối đe dọa an ninh chứ không chỉ tranh chấp sở hữu trí tuệ. Với doanh nghiệp Việt Nam, hành động cụ thể nên làm ngay là rà lại log của mọi tài khoản API đang chạy tự động, xem có tiến trình nào hoạt động đều đặn mà không ai nhận là của mình không.

Positron AI gọi 875 triệu USD ở định giá 5 tỷ, đặt cược chip inference dùng bộ nhớ phổ thông

Positron AI huy động 875 triệu USD chia hai đợt ở định giá sau đầu tư 5 tỷ USD, công bố ngày 10/09. Chip Asimov ghép 288 GB tới 2.304 GB bộ nhớ LPDDR5X phổ thông cho mỗi chip, né hoàn toàn nút thắt nguồn cung HBM và đóng gói tiên tiến, dự kiến tape-out trên tiến trình TSMC N3P cuối 2026 và sản xuất nửa cuối 2027.

💡 Nếu bỏ HBM mà vẫn chạy được inference thì nút cổ chai đắt nhất của ngành bị tháo, và đây là đòn đánh thẳng vào thế độc quyền của NVIDIA ở mảng suy luận.

📅 10/09 🔗 Website
  • Huy động 875 triệu USD chia hai đợt, công bố 10/09
  • Định giá sau đầu tư 5 tỷ USD
  • Chip Asimov dùng 288 GB tới 2.304 GB LPDDR5X phổ thông
  • Né hoàn toàn nút thắt nguồn cung HBM và đóng gói tiên tiến
  • Tape-out TSMC N3P cuối 2026, sản xuất nửa cuối 2027
NGÀY10/09/2026VỐN875 triệu USDĐỊNH GIÁ5 tỷ USDBỘ NHỚ288GB - 2.304GBTIẾN TRÌNHTSMC N3P

Điểm đáng nói về mặt kỹ thuật là quyết định bỏ HBM. Bộ nhớ băng thông cao là thứ đắt nhất và khan hiếm nhất trong chuỗi cung ứng AI hiện nay, và nó cũng là lý do lớn khiến giá GPU cao đến vậy. Positron đánh cược rằng với suy luận, thứ quyết định là dung lượng bộ nhớ chứ không phải băng thông tối đa, nên LPDDR5X phổ thông là đủ. Nếu cược đúng thì nút cổ chai đắt nhất của ngành bị tháo và giá suy luận giảm mạnh. Nhưng cần đọc kỹ mốc thời gian: chip mới tape-out cuối 2026 và sản xuất nửa cuối 2027, tức nhà đầu tư đang trả 5 tỷ đô cho một sản phẩm chưa ra khỏi xưởng. Với người mua hạ tầng ở Việt Nam, đây là tin để theo dõi chứ chưa phải để tính vào kế hoạch mua sắm.

Microsoft nhắm 38 GW công suất data center vào 2032, gấp hơn ba lần hiện tại

Theo Bloomberg dẫn nguồn thân cận, Microsoft đặt mục tiêu nâng tổng công suất tính toán từ khoảng 12 GW hiện nay lên hơn 38 GW vào năm 2032, gồm cả cơ sở tự vận hành lẫn thuê lại. Phần dành riêng cho AI dự kiến tăng từ 2 GW lên khoảng một phần ba tổng công suất.

💡 Microsoft vừa phải từ chối khách cloud và hạn chế đăng ký vì thiếu phần cứng, nên con số này là thước đo thật của việc cầu AI đang vượt cung tới mức nào.

📅 10/09 🔗 Website
  • Bloomberg dẫn nguồn thân cận, đưa tin ngày 10/09
  • Nâng công suất từ khoảng 12 GW lên hơn 38 GW vào 2032
  • Gồm cả cơ sở tự vận hành lẫn thuê lại
  • Phần dành cho AI tăng từ 2 GW lên khoảng một phần ba tổng
  • Đã phải từ chối khách cloud vì thiếu phần cứng
NGÀY10/09/2026HIỆN TẠI~12 GWMỤC TIÊU 203238+ GWAI HIỆN NAY2 GWCAPEX 2026175 tỷ USD

Con số nói lên tình trạng thật rõ hơn mọi phát biểu lạc quan: Microsoft đã phải từ chối khách cloud và hạn chế đăng ký vì không đủ phần cứng. Đó không phải chiến lược mà là thiếu hụt. Kế hoạch nâng gấp hơn ba lần công suất trong sáu năm là cam kết vốn khổng lồ, và mức capex 175 tỷ đô cho năm 2026 cho thấy họ đang trả giá thật cho việc bắt kịp. Với doanh nghiệp Việt Nam dùng dịch vụ đám mây, hệ quả trực tiếp là năng lực GPU ở khu vực sẽ còn căng trong vài năm tới, và giá khó giảm sâu như kỳ vọng. Nếu kế hoạch của bạn giả định giá suy luận sẽ rẻ đi nhanh, hãy tính thêm một kịch bản giá đi ngang. Đây cũng là lập luận mạnh cho việc tự host model mở như DeepSeek V4.1-Flash.

🔥 TOP 5 TUẦN NÀYCognition gọi hơn 2 tỷ USD Series E ở định giá 48 tỷ, gần gấp đôi sau bốn tháng

Cognition, công ty đứng sau kỹ sư phần mềm AI Devin, công bố ngày 08/09 huy động hơn 2 tỷ USD Series E ở định giá 48 tỷ USD, do Andreessen Horowitz và Accel dẫn dắt cùng Founders Fund, General Catalyst, Avenir và cả NVIDIA. Doanh thu run-rate tăng từ 492 triệu USD hồi tháng 5/2026 lên gần 900 triệu USD.

💡 Định giá gần gấp đôi trong bốn tháng và doanh thu tăng gần gấp đôi cùng kỳ cho thấy agent lập trình đã qua giai đoạn thử nghiệm và đang được doanh nghiệp trả tiền thật.

📅 08/09 🔗 Website
  • Công bố ngày 08/09, huy động hơn 2 tỷ USD Series E
  • Định giá 48 tỷ USD, gần gấp đôi sau bốn tháng
  • a16z và Accel dẫn dắt, có cả NVIDIA tham gia
  • Doanh thu run-rate từ 492 triệu lên gần 900 triệu USD
  • Devin ra mắt hai năm trước như kỹ sư phần mềm AI đầu tiên
NGÀY08/09/2026VỐN2+ tỷ USDĐỊNH GIÁ48 tỷ USDDOANH THU~900 triệu USDTĂNG TRƯỞNG~2x / 4 tháng

Con số cần nhìn ở đây là doanh thu chứ không phải định giá. Định giá là kỳ vọng của nhà đầu tư và có thể sai; doanh thu run-rate gần 900 triệu đô là tiền doanh nghiệp đang thật sự trả hàng tháng. Khi Devin ra mắt hai năm trước, phần lớn giới kỹ thuật hoài nghi rằng demo không phản ánh năng lực thật, và sự hoài nghi đó có cơ sở vào thời điểm ấy. Con số hôm nay trả lời câu hỏi rõ hơn mọi bản demo. Đặt cạnh việc OpenAI mở Agents API trong cùng tuần, bức tranh khá rõ: agent lập trình đã rời giai đoạn thử nghiệm để bước vào giai đoạn hạ tầng. Với đội phát triển ở Việt Nam, câu hỏi thực tế không còn là agent có dùng được không, mà là quy trình review và trách nhiệm code của bạn đã sẵn sàng cho việc phần lớn code do máy viết chưa.

Mistral gọi 3 tỷ euro do Samsung dẫn dắt, định giá vượt 21 tỷ euro

Mistral công bố ngày 08/09 huy động 3 tỷ euro vòng Series D ở định giá sau đầu tư hơn 21 tỷ euro, vòng gọi vốn tư nhân lớn nhất lịch sử ngành công nghệ châu Âu. Samsung Electronics dẫn dắt cùng Scaleup Europe Fund do EQT quản lý và PSG Equity, với sự tham gia của NVIDIA, ASML, BlackRock và Đại công quốc Luxembourg.

💡 Định giá gần gấp đôi sau một năm và có cả ASML lẫn một chính phủ tham gia cho thấy AI chủ quyền đã thành hạng mục đầu tư chiến lược quốc gia chứ không còn là khẩu hiệu chính trị.

📅 08/09 🔗 Website
  • Công bố ngày 08/09, gọi 3 tỷ euro vòng Series D
  • Định giá sau đầu tư hơn 21 tỷ euro
  • Vòng gọi vốn tư nhân lớn nhất lịch sử công nghệ châu Âu
  • Samsung Electronics dẫn dắt, cùng Scaleup Europe Fund và PSG Equity
  • NVIDIA, ASML, BlackRock và Luxembourg cùng tham gia
NGÀY08/09/2026VỐN3 tỷ EURĐỊNH GIÁ21+ tỷ EURDẪN DẮTSamsungTRƯỚC ĐÓ11,7 tỷ EUR

Danh sách nhà đầu tư nói nhiều hơn con số. Khi có cả ASML, công ty độc quyền máy quang khắc cực tím, lẫn một chính phủ châu Âu cùng vào một vòng gọi vốn, đó không còn là đầu tư tài chính thuần túy mà là định vị chiến lược quốc gia. Cụm từ AI chủ quyền từng bị coi là khẩu hiệu chính trị, giờ có ba tỷ euro đứng sau. Việc Samsung dẫn dắt cũng đáng chú ý vì nó nối Mistral với chuỗi cung ứng bán dẫn châu Á, thứ mà một công ty châu Âu thuần túy sẽ thiếu. Với Việt Nam, đây là mô hình tham chiếu đáng đọc kỹ: một quốc gia tầm trung có thể xây năng lực AI riêng bằng cách kết hợp vốn nhà nước, trọng số mở và đối tác phần cứng, thay vì chỉ mua dịch vụ của các hãng Mỹ.